说到接口的成功和失败,大家先想到的往往都是 HTTP 状态码:200 就是成了,其他的就是没成。但是当一次请求要同时去查好几个地方的时候,结果往往不是全成或者全败。以前的接口是写给人写的程序去读的,而 Cortrix 首要的服务对象是 Agent,我们把这种设计取向叫作 Agent First。在这种情况下,Cortrix 返回的是部分成功响应。这篇我们会剖析 Cortrix 在一部分数据查不到的时候返回了什么,Agent 应该怎么使用它,以及什么样的调用应该把它当成失败来处理。
一次查询只成功了一半,咋办?
这里,我们拿客服 Agent 举个例子。业务场景中用户问了一句「我的退款到哪一步了」,Agent 需要同时去查两个地方:业务政策库里的退款规则,以及订单库里这位用户的订单记录。就在这一秒,订单库没有响应。
这时候接口有两种做法。一种是整个请求报错,那么业务政策库明明已经查到了结果,Agent 也用不上,只能两手空空地回去重来。另一种是把业务政策库的结果先交给 Agent,同时告诉它订单库这一次没有查到、为什么没有查到、能不能再试一次。
Cortrix 有自己的「Agent First 美学」,我们选后一种。一次查询可以跨多个命名空间,当其中一个失败的时候,请求仍然返回 HTTP 200,成功的部分照常给出,失败的部分写在响应的 meta 里。
下面这个图,画的是 Cortrix 的部分成功响应:一次查询里一部分失败时,返回了什么,Agent 接下来可以做什么。
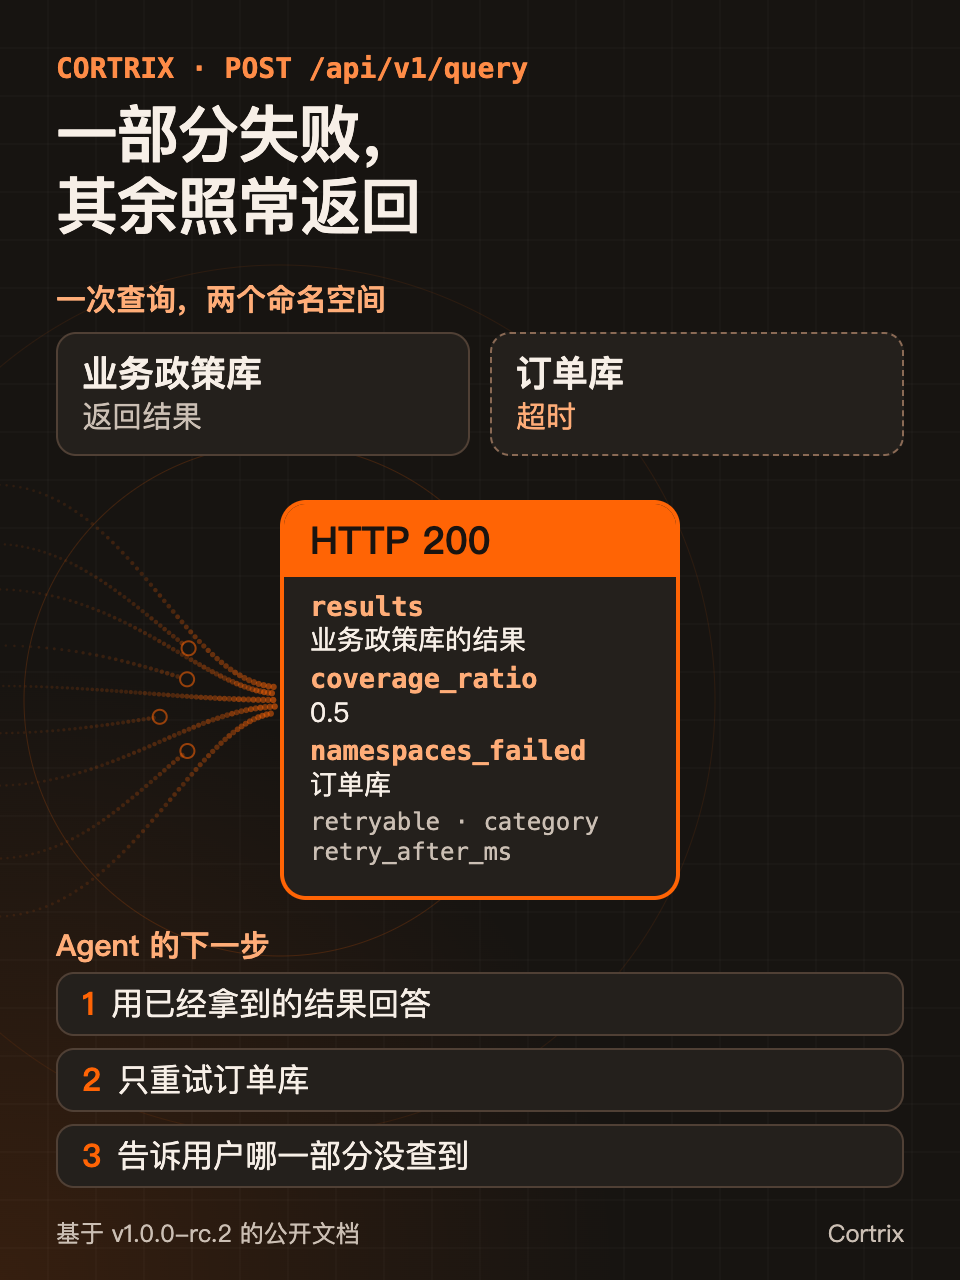
图 1|Cortrix 的部分成功响应:一部分失败时返回了什么,Agent 接下来可以做什么。
在一次请求里返回部分结果这个方向,业界也有不少实践。Elasticsearch 的搜索接口默认允许返回部分结果,当某些分片超时或者失败的时候,其余分片的结果照常返回。
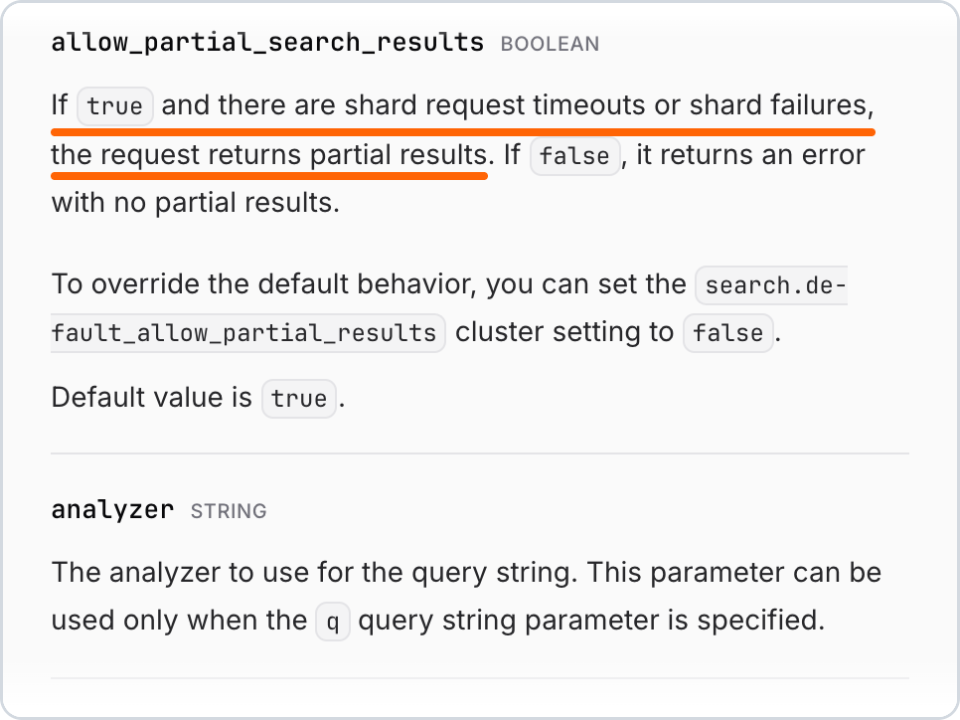
图 2|Elastic 文档对 allow_partial_search_results 的说明,截于 2026-10-12,橙色横线是本文加的。见参考资料 [1]
Amazon S3 一次删除多个对象的时候,如果其中一个删不掉,响应仍然是 200,并且逐个对象说明是成功还是失败。
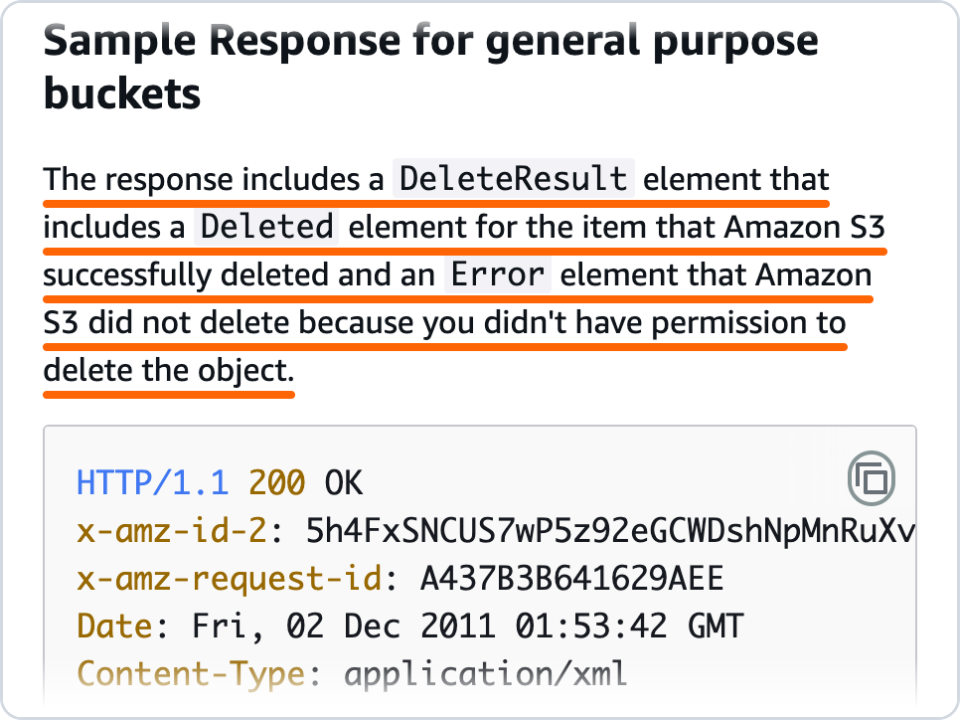
图 3|Amazon S3 的 DeleteObjects 接口说明,截于 2026-10-12。见参考资料 [2]
GraphQL 的规范也写明,一个响应可以同时带着部分数据和字段级的错误。
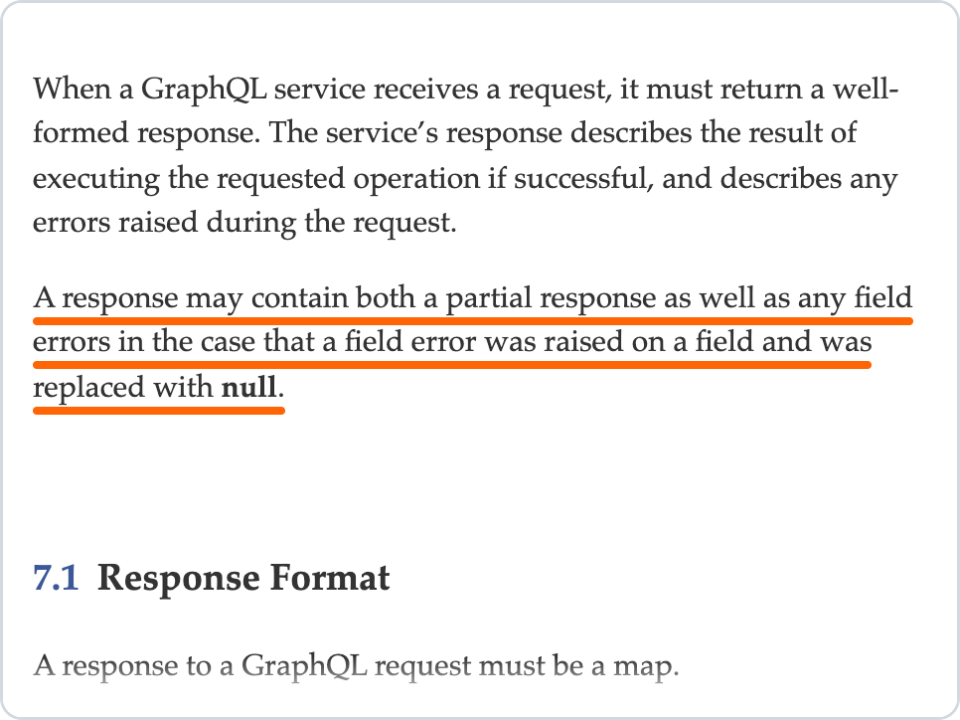
图 4|GraphQL 规范对响应里 data 和 errors 的说明,截于 2026-10-12。见参考资料 [3]
这些做法面向的都是人写的程序,由生硬的程序逻辑去读文档、判断怎么处理。Cortrix 在这个方向上的思考是 Agent First:我们首要的服务对象是 Agent,所以每一项失败都直接带上「能不能重试」「属于哪一类问题」「建议等多久」,Agent 不需要去解析报错文本,就可以自己决定下一步。
我们所说的 Agent First 美学,指的是在设计接口的时候,先考虑 Agent 拿到这份响应之后能不能直接往下走。因此,能给的结果先交给它,缺了什么如实告诉它,下一步可以怎么做也直接写在响应里,而不是让它自己去猜。
Agent First 的响应
下面是文档站(基于 v1.0.0-rc.2)的例子。guide 是一个有数据的命名空间,nope 用来模拟一个查不到的范围:
curl -fsS -H 'Content-Type: application/json' \
  -d '{"namespaces": ["guide", "nope"], "query": "refunds", "top_k": 2}' \
  http://127.0.0.1:8420/api/v1/query
请求返回的是 200,results 里是 guide 的结果。这个例子里失败的原因和前面场景里的超时不一样:nope 是一个查不到的范围,所以它被标成了不可以重试。超时的情况在后面会讲到。这一次的 meta 是这样的:
{
  "coverage_ratio": 0.5,
  "namespaces_failed": [
    {
      "category": "permanent",
      "error_code": "CX_ERR_INDEX_CORRUPT",
      "message": "CX_ERR_INDEX_CORRUPT",
      "namespace": "nope",
      "retry_after_ms": null,
      "retryable": false,
      "structured_data": { "index_state": "unavailable", "namespace": "nope" }
    }
  ],
  "namespaces_queried": ["guide", "nope"],
  "namespaces_succeeded": ["guide"]
}
meta 里有两个字段是专门为 Agent 准备的:
coverage_ratio:表示完整度的数字。这里的 0.5 说明两个命名空间里只查到了一个。只要它小于 1,就代表这一次的结果只覆盖了一部分范围。namespaces_failed:逐项的失败清单。每一项都会指明是哪个命名空间,并且直接回答接下来应该怎么办:retryable:值不值得重试。retry_after_ms:建议等多久之后再试。category:这是哪一类问题。
category 一共有五种,对应的处理方式是:
auth、permanent:不应该原样重试。transient、timeout:可以等过建议的时间之后再试。quota:需要先减小请求的规模或频率。
这里有一个细节。nope 其实是一个不存在的命名空间,但是查询接口的响应并没有直接说「不存在」,而是报成了不可用。Cortrix 的公开源码把查询接口的这种处理描述为防枚举的设计。
在实际的业务运行中,另一种情况是超时。每个命名空间都有自己的时间预算,超时的那一个会被记成 CX_ERR_NS_TIMEOUT,并且标为可以重试,而其余命名空间的结果照常返回。
同样的规则也用在批量提交文档上。一次最多可以提交 100 篇文档,当部分文档失败的时候,请求仍然返回 200,失败的那几篇会列在 meta.failed[] 里,每一项同样带着 retryable、category 和 retry_after_ms。
哪些 Agent 调用需要部分成功响应
我们的建议是,先看调用方是谁,以及它拿这份结果去做什么。
-
如果:调用方是一个正在为回答收集材料的 Agent,那么
部分成功响应会有帮助。Agent 可以先使用已经拿到的结果,把可以重试的那一部分单独重试,并且在回答里向用户说明哪一部分这次没有查到。这样它就不会拿着半份材料,给出一个看起来很完整的答案。 -
如果:调用方做的是评测、对账、批处理,或者需要给出「一共多少条」这样的统计,那么应该把
coverage_ratio小于 1 当成失败来处理,重跑或者剔除这一次的结果。因为在这一类业务里,一份不完整的结果被当成正常结果记录下来,比直接报错更难被发现。 -
如果:你正在给系统做监控,需要注意状态码是看不到部分失败的。应该给
coverage_ratio和namespaces_failed单独打点,这样在仪表盘上才能看得见。按公开源码,即使所有命名空间都失败了,请求返回的仍然是 200,这时候coverage_ratio是 0,results是空的。 -
如果:调用方是你控制不了的客户端,或者中间隔着只看状态码的网关和重试中间件,那么建议在自己的服务这一层,把不完整的结果转成错误之后再往外传。
在 Cortrix 中,我们为每一个查询响应都提供了 coverage_ratio 和 namespaces_failed,帮助对接的 Agent 直接做出判断。你可以像下面这样处理一次查询,这里用的是 Python SDK 的写法,retry_later、note_missing 和 answer_with 代表你自己的业务函数:
from cortrix import Cortrix

client = Cortrix(base_url="http://localhost:8420", api_key="your-cortrix-api-key")
resp = client.search(["policy", "orders"], question)

if resp.meta.coverage_ratio < 1:
    for failed in resp.meta.namespaces_failed or []:
        if failed["retryable"]:
            # 只重试失败的那一个命名空间,等它建议的时间
            retry_later(failed["namespace"], wait_ms=failed["retry_after_ms"] or 1000)
        else:
            # 记下来,回答的时候说明这一部分没有查到
            note_missing(failed["namespace"], failed["category"])

answer_with(resp.results)
在对接的时候,应该以响应里的 retryable 和 category 为准来决定怎么处理,而不要依赖错误码的字面写法。
需要一起留意的两种情况
第一种是请求本身写错了。这时候 Cortrix 仍然会用 4xx 来回应,而不是 200。比如查询里用了已经废弃的单数 namespace 字段,返回的是 400,并且会在 structured_data 里告诉你应该换成 namespaces。部分成功响应只出现在请求本身没有问题、但是其中一部分范围没有查成的时候。
第二种是异步处理。上传请求成功,只说明任务已经被接受,文档处理得怎么样,需要去看任务进度。任务进度里带着一个 agent_decision_hint:值是 done_fetch_doc 的时候可以去读文档,值是 inspect_error_code 的时候应该去看错误码。内联上传的时候,即使命名空间写错了,请求也会先返回 202,问题要到任务进度里才能看到。
用 Cortrix 还是自己写 Glue code
如果你不是使用 Cortrix 作为 Agent 的语义存储(Semantic Storage),同样的检查在别的系统里也需要做。使用 Elasticsearch 的时候,应该去看响应里的 _shards.failed,或者把 allow_partial_search_results 设成 false,让它在结果不完整的时候直接报错。使用 S3 批量删除的时候,应该逐项去看有没有 Error。使用 GraphQL 的时候,data 和 errors 两个都需要看。
如果你想要在自己的接口里实现部分成功响应,让 Agent 能够直接使用,下面这四个问题必须处理好:
- 响应里要有一个表示完整度的数字。调用方只看这一个数字,就应该能知道这一次的结果是不是完整的。
- 响应里要有逐项的失败清单。只告诉调用方「有一部分失败了」是不够的,它需要知道失败的具体是哪一部分。
- 每一项失败都要带上「能不能重试」和「属于哪一类问题」。少了这两项,对接的 Agent 就只能回头去解析报错文本,无法做后续的业务判断。
- 可以重试的失败,要给出建议等待的时间。否则调用方只能自己猜,要么重试得太急,要么等得太久。
这四件事各自都要写「Glue code(胶水代码)」,并且需要在每一个会返回部分结果的接口上保持一致,之后还要作为独立的模块长期维护。如果你不想手搓这些代码,也不想在未来给自己管理增加工作量,那就还是直接使用 Cortrix 吧。让自己专注于处理业务工作,把复杂的数据管理交给我们。以上特性都已经在 Cortrix 的查询和批量提交接口里:完整度用 coverage_ratio 表示,查询的失败逐项列在 namespaces_failed 里,批量提交的失败逐项列在 meta.failed[] 里,每一项都带着 retryable、category 和 retry_after_ms。
怎么在自己的机器上验证
按 Quickstart 把 Cortrix 跑起来之后,不需要再准备任何数据。Quickstart 会预置一个叫 demo 的命名空间,下面三条命令用它就可以看到本文讲的部分成功响应。命令和输出都来自 v1.0.0-rc.2 上的实跑。
第一条,同时查 demo 和一个不存在的 nope,只看状态码:
curl -sS -o /dev/null -w '%{http_code}\n' -H 'Content-Type: application/json' \
  -d '{"namespaces": ["demo", "nope"], "query": "语义存储把什么放在离 Agent 更近的地方?", "top_k": 2}' \
http://127.0.0.1:8420/api/v1/query200第二条,还是同一个请求,这一次把 Agent 要用的几个字段打印出来:
curl -sS -H 'Content-Type: application/json' \
  -d '{"namespaces": ["demo", "nope"], "query": "语义存储把什么放在离 Agent 更近的地方?", "top_k": 2}' \
  http://127.0.0.1:8420/api/v1/query \
  | python3 -c 'import json,sys; d=json.load(sys.stdin); m=d["meta"]; f=m["namespaces_failed"][0]; print(m["coverage_ratio"], len(d["results"]), f["namespace"], f["retryable"], f["category"])'
0.5 1 nope False permanent这一行依次是 coverage_ratio、拿到的结果条数、失败的命名空间、retryable 和 category。也就是说,这次查询只成功了一半:demo 的 1 条结果照常返回,nope 被标成了不可以重试。
第三条,两个命名空间都查不到:
curl -sS -w '\n%{http_code}\n' -H 'Content-Type: application/json' \
  -d '{"namespaces": ["nope", "nope-2"], "query": "语义存储把什么放在离 Agent 更近的地方?", "top_k": 2}' \
  http://127.0.0.1:8420/api/v1/query \
  | python3 -c 'import json,sys; body,status=sys.stdin.read().strip().rsplit("\n",1); d=json.loads(body); print(status, d["meta"]["coverage_ratio"], len(d["results"]))'
200 0.0 0这一行依次是状态码、coverage_ratio 和结果条数。状态码仍然是 200,而结果是 0 条。只看状态码的监控,会把这一次当成一次正常的查询。
如果把请求里的 namespaces 写成已经废弃的单数 namespace,返回的就是 400,而不是部分成功响应。
常见问题
部分成功响应是什么
部分成功响应是 Cortrix 语义存储在一次查询只成功了一部分时返回的结果。请求仍然返回 HTTP 200,成功的部分照常给出,meta 里的 coverage_ratio 说明完整度,namespaces_failed 逐项列出失败的命名空间。
返回 HTTP 200,是不是代表这次查询的结果是完整的
不一定。需要看响应里的 coverage_ratio,只要它小于 1,就代表这一次的结果只覆盖了一部分范围。
什么时候应该把部分成功响应当成失败
做评测、对账、批处理,或者需要给出总数统计的时候,应该把 coverage_ratio 小于 1 当成失败,重跑或者剔除这一次的结果。如果是 Agent 在为回答收集材料,则可以先使用已有的结果,并向用户说明哪一部分没有查到。
Agent First 是什么意思
Agent First 是 Cortrix 设计接口时的取向:首要的服务对象是 Agent,所以每一项失败都直接带上能不能重试、属于哪一类问题、建议等多久,Agent 可以据此自己决定下一步。Cortrix 的文档站把这个取向写作 agent-native,它和这里说的 Agent First 指的是同一件事。
参考资料
- [1] Elastic Docs, Run a search:https://www.elastic.co/docs/api/doc/elasticsearch/operation/operation-search
- [2] Amazon S3 API Reference, DeleteObjects:https://docs.aws.amazon.com/AmazonS3/latest/API/API_DeleteObjects.html
- [3] GraphQL Specification, October 2021, Response:https://spec.graphql.org/October2021/#sec-Response
- [4] Cortrix GitHub 仓库:https://github.com/cortrix/cortrix
- [5] Cortrix Quickstart:https://cortrix.ai/docs/get-started/quickstart/
- [6] Cortrix 文档站,接口约定:https://cortrix.ai/docs/concepts/interfaces/
- [7] Cortrix 文档站,错误码:https://cortrix.ai/docs/reference/errors/
- [8] Cortrix 文档站,查询与重排:https://cortrix.ai/docs/guides/query/
本文讲的行为对应 Cortrix v1.0.0-rc.2,这是一个预发布版本。命名空间是逻辑上的查询范围,在 v1.0.0-rc.2 的本地运行时里不构成权限边界。