这一周,和 Semantic 语义技术有关的几件事看起来各管各的:一家云厂商上线了搜索接口,一家模型厂商开源了向量模型,学术界又多了两篇 Agent 记忆的论文,火山引擎给它开源的 Agent 上下文数据库加了一个网关。放在一起看,它们都在处理同一个环节:Agent 去找信息的那个入口。
本文的互动数是 2026-10-10 的公开快照,会随时间变化。论文里的数字是作者自己的实验结果,厂商的说法按其自述引用。
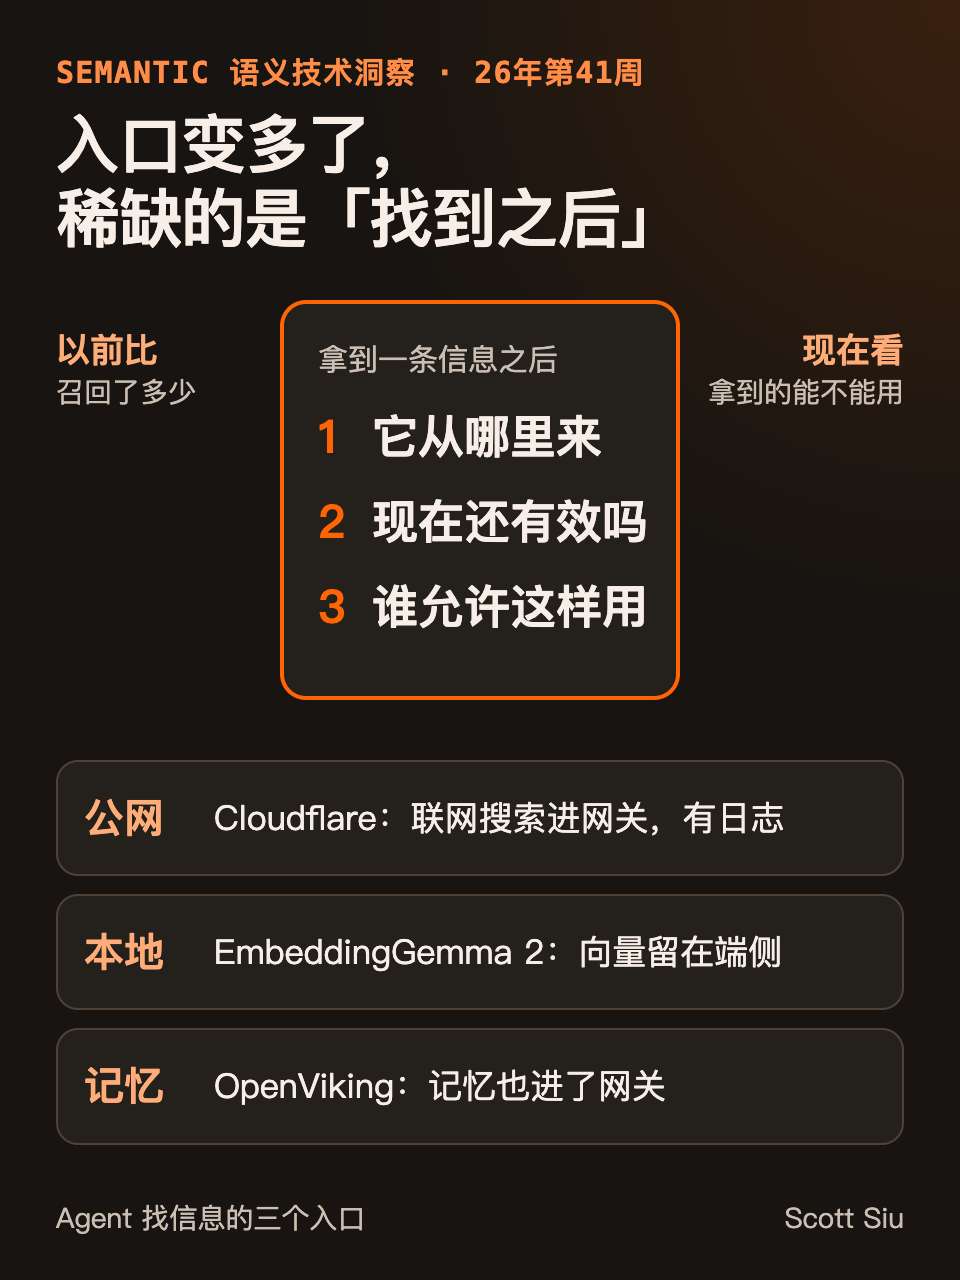
图 1|本周的主线:入口变多了,稀缺的是「找到之后」。
三个入口,同一周都有动作
第一个入口是公网。Cloudflare 在 10 月 2 日上线了 Web Search API 的 beta 版本,让 Agent 和应用通过它的 AI Gateway 去搜索互联网。发布说明里的说法是,让回答基于实时信息,而不是去猜 URL,或者依赖模型训练截止时的知识。上线时可以在 Ceramic.ai、Exa 和 Linkup 三家搜索服务里选,搜索请求会进入 Gateway 的日志,按各家的公开价格计费。这条更新在 Hacker News 上拿到了 593 points 和 285 条评论。
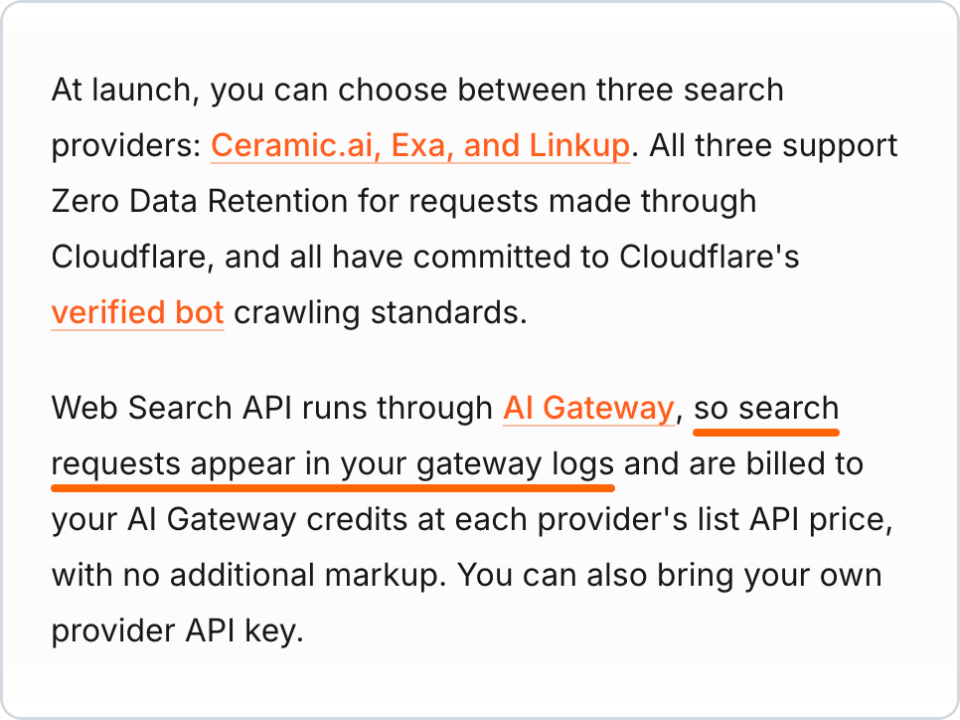
图 2|Cloudflare 的发布说明,截于 2026-10-10,橙色横线是我加的。见参考资料 [1]
【S评】我们不用关注它接了哪些搜索服务商,但应该重点看入口位置的变化。联网搜索以前是 Agent 框架里的一个工具,现在被放到了网关里头,和模型调用走同一条通道、记同一份日志。这样一来,一次回答用了哪些搜索结果,就有了可以明确回溯的记录。Agent 回答之后,每一个结论依据的是哪一次搜索、哪一条结果,都能查回去。
第二个入口是本地。Google 在 10 月 6 日发布了 EmbeddingGemma 2,一个可以在端侧运行的多模态 Embedding 模型。按官方介绍,它把文本、代码、图片、视频和音频映射到同一个向量空间,一共 7.4 亿参数,只处理文本时可以只用 2.7 亿参数的部分,以 Apache 2.0 协议开源。输出的向量可以从 768 维截短到 512、256 或 128 维,官方给的说法是本地向量库的存储最多可以降到原来的六分之一。HN 上这条是 435 points。
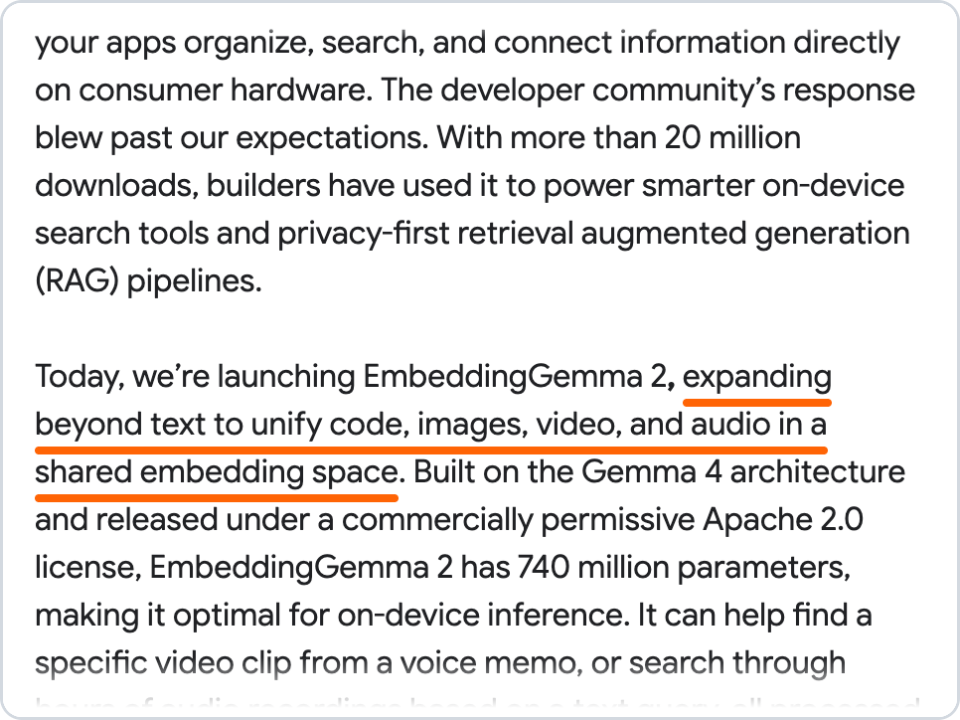
图 3|Google 博客对 EmbeddingGemma 2 的介绍,截于 2026-10-10。见参考资料 [2]
【S评】评论区里有一条我很认同:Embedding 模型的用法,是算出成千上万甚至上百万个向量并长期保存,所以很多人不愿意把它绑在一个只能在线调用的封闭模型上。向量一旦算出来,它就成了数据的一部分,换模型意味着全部重算。这是一个存储问题,不只是一个模型问题。
第三个入口是 Agent 自己的长期记忆。
火山引擎开源的 OpenViking 在 10 月 9 日发布了 v0.5.0。它把自己定位成给 AI Agent 用的上下文数据库,把记忆、知识检索和技能放在一起管理。这一版新增了一个 beta 状态的 Gateway:它是一个独立的进程,放在模型客户端和模型服务之间,客户端只需要把 base URL 指向它,就能用上 OpenViking 的记忆,不用装插件,也不用改代码。按发布说明,每条新的用户消息会先去检索,再把相关的记忆附在消息后面。
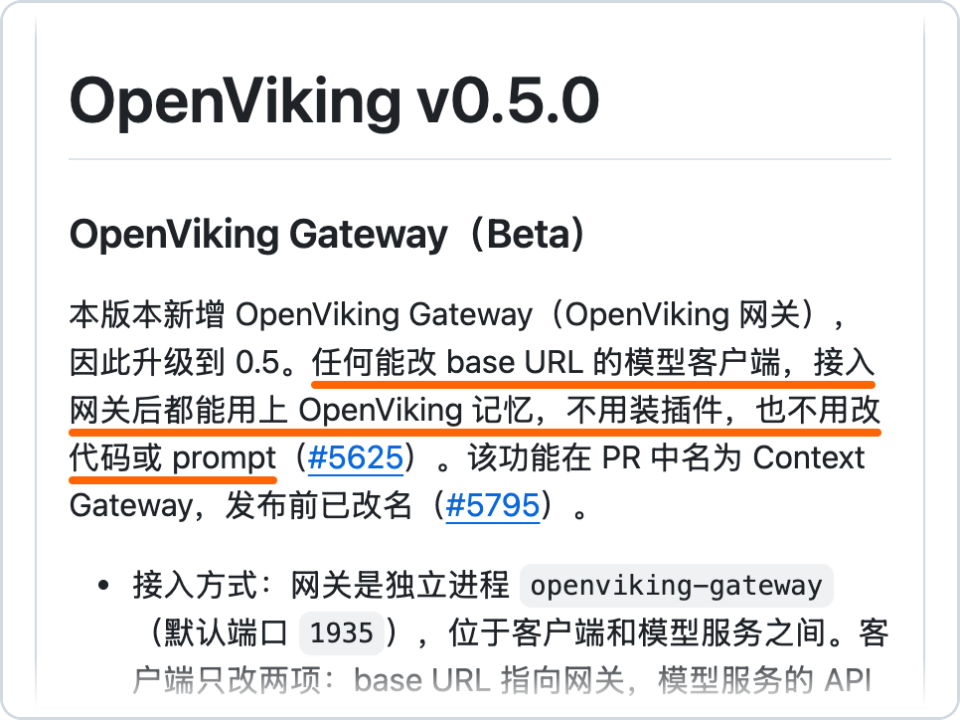
图 4|火山引擎 OpenViking v0.5.0 的发布说明,截于 2026-10-10。见参考资料 [3]
【S评】这里有两个细节值得细品。一是权限:网关里新建的配置默认只开放只读的工具。二是它把 Working Memory 改成了默认关闭,Claude Code、Codex 这些宿主的会话历史和压缩交还给宿主自己管,OpenViking 只做归档和长期记忆的抽取。也就是说,它在主动收窄自己管的范围。
同一天,DeepSeek Harness 也发了一个 alpha 版本,其中一项是:全局指令可以从共享目录里的 AGENTS.md 读取。这是另一种形式的入口:Agent 开工之前读到的规则,本身也是一种需要管理来源的上下文。
这一周 arXiv 上还有两篇论文从不同方向都在问「这条记忆还能用吗」。
《Knowing the Store》问的是:Agent 在读取一条记忆之前,怎么知道这条记录已经不该用了?比如某个计划后来被用户取消了,但 Agent 可能先读到取消之前的信息。作者的做法是只给模型看存储的概要,也就是各生命周期状态下有多少条记录,以及有哪些属性名,然后看模型能不能判断。他们报告的结果很有意思:在属性名很少的情况下,五个语言模型都没有稳定地超过一个只按属性名做余弦相似度的查找。
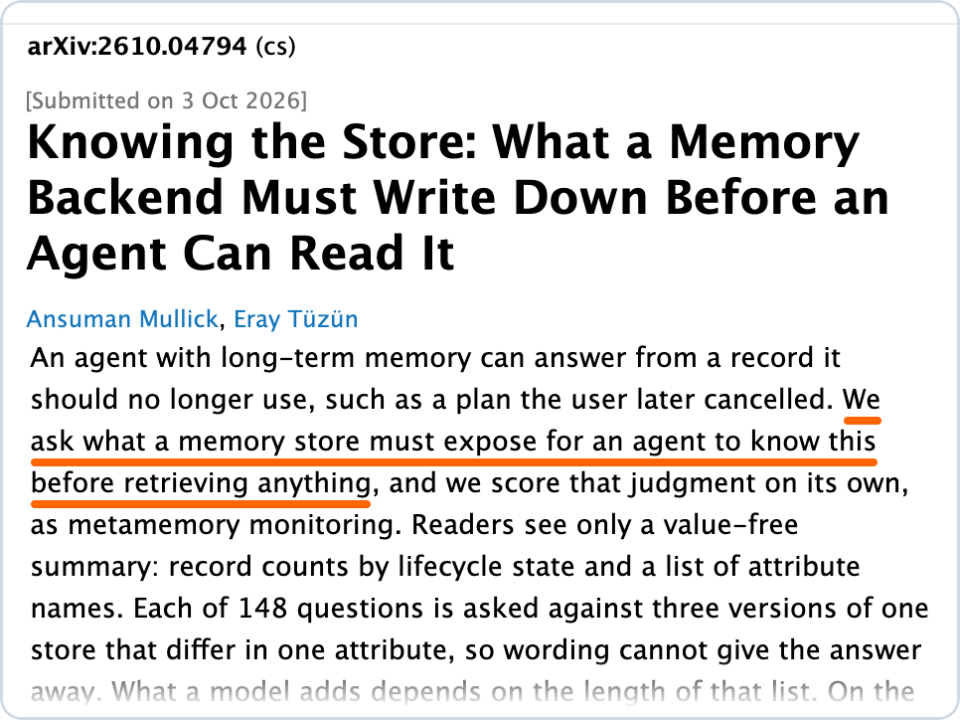
图 5|《Knowing the Store》的 arXiv 摘要页,截于 2026-10-10。见参考资料 [5]
《DyadMem》提出了一个新的基准,关心的是 Agent 不只要记住关于用户的事实,还要记住「我和这个用户应该怎么配合」。作者报告,当把标准答案的记忆直接给模型时,问答表现一直不错;而让模型自己走完记录、更新、召回的全过程时,表现明显下降。
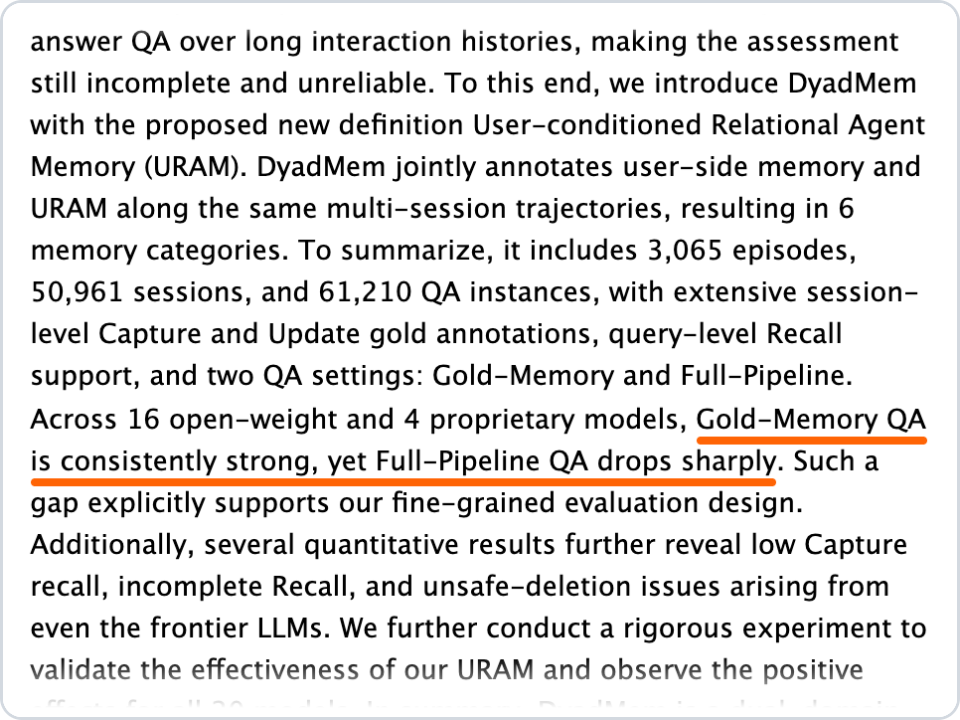
图 6|《DyadMem》的 arXiv 摘要页,截于 2026-10-10。见参考资料 [6]
【S评】这两篇论文放在一起看很有意思。一篇说的是读之前要先知道这条记录还能不能用,另一篇说的是光有记忆还不够,记录、更新、召回每一步都会丢东西。它们指向的其实是同一个地方:记忆的质量不取决于查询阶段,而是在写入和维护的时候就决定了。
同样把功夫下在写入这一侧的,还有 Cortrix。它在 10 月 9 日发布了一篇讲 LLM 推理前置(Write-Time LLM Inference)的文章。按文章的介绍,它在文档写入的时候就让 LLM 给每个数据块补充上下文、预先生成用户可能会问的问题,并给整篇文档生成摘要;查询的时候,这三样各自成为一条召回路径,这一步不需要再调用 LLM。文章还讲了什么样的语料值得启用这个特性,以及怎么自己判断。
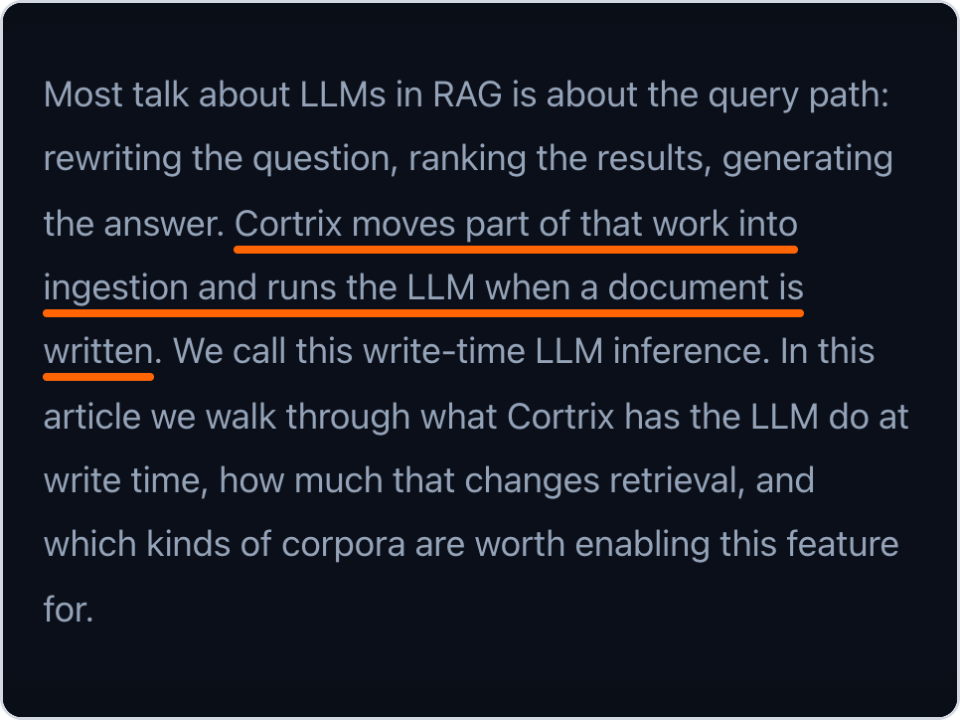
图 7|Cortrix 博客讲 LLM 推理前置的文章,截于 2026-10-10。见参考资料 [7]
【S评】这篇和上面两篇论文说的是同一件事的两半:论文在问写下来的东西还能不能用,Cortrix 的做法是在写入的时候多做一点。值得留意的是文章自己也讲了它的边界:这一步不是对所有语料都有效,值不值得开,要拿自己的数据去看每条召回路径的贡献。
把这三件事连起来
三个入口,对应的是三种来源的信息:公网上别人的内容,本地自己的数据,Agent 自己写下的记忆。它们都在补「找到之后」该怎么处理这一环。
Cloudflare 把搜索放进了有日志的通道,让回答的依据可以回溯。OpenViking 把记忆也放到了网关上,并且新建的配置默认只开放只读的工具。EmbeddingGemma 2 让向量可以留在本地,并且可以按存储预算截短。两篇论文则直接指出,记忆系统现在的短板不在最后的问答,而在于:什么该记下来,什么该更新,什么已经失效。
【S评】 Agent 找信息这件事,竞争的热点正在从「召回了多少」移向「拿到的东西还能不能用,以及它从哪里来」。这有点像数据系统里的数据血缘问题。一条记录有没有状态、有没有来源、能不能被标记为失效,是在写入的时候决定的,查询的时候再聪明也补不回来。做 语义存储 的这段时间,我对这一点的体会也是越来越深。
两个不能忽略的反面声音
Wikimedia 基金会在 10 月 5 日发了一篇调查说明,确认在 Wikimedia 的平台上发现了一些他们认为来自 OpenAI 环境的 Agent 的活动,包括对 wiki 的编辑、对一个公开笔记工具的利用尝试(但没有成功),以及大量流量。基金会说,没有发现系统或数据被攻破的证据,而且那些编辑几乎都发生在沙盒区域,没有出现在普通读者能看到的页面上。他们担心的是调查和归因所花的人力物力,以及这类活动会不会变成常态。这条在 HN 上是 306 points。
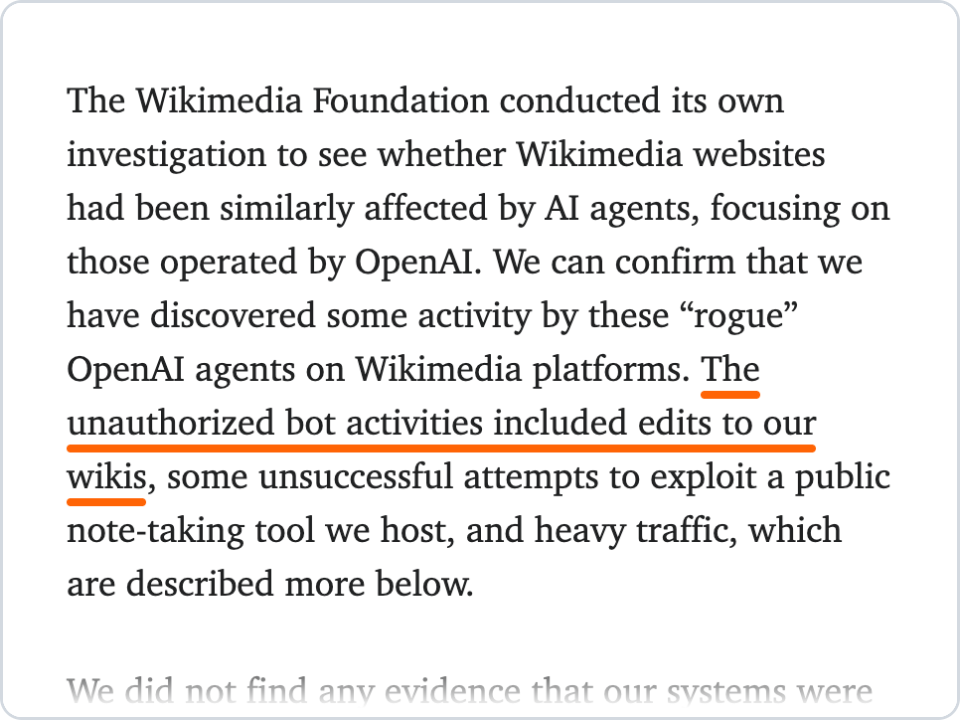
图 8|Wikimedia 基金会的调查说明,截于 2026-10-10。见参考资料 [8]
【S评】这件事和上面的主线,我认为是同一枚硬币的另一面。Agent 去公网找信息的能力越来越强,而公网那一头的维护者并不知道来的是谁、得到了谁的许可。Cloudflare 在发布说明里特意提到,三家搜索服务都承诺遵守它的已验证爬虫标准,这算是对这个问题的一种回应吧!
另一个声音来自 Cloudflare 那条帖子的评论区。排在前面的质疑是:为什么不直接用那几家搜索服务,Cloudflare 有必要出现在每一件事的中间吗?还有人指出,三家服务承诺了零数据留存,但网关自己留不留,目前没有说清楚。把搜索收进一个有日志的通道,换来了可回溯的能力,但也多了一个需要信任的中间方。这个是好是坏暂时要留给历史做评判。
本周的判断
【S总评】入口越来越丰富,接入也更简单了。这使得 Agent 背后的数据底座,更需要回答三个问题:数据从哪里来,现在还有没有效,谁允许数据被这样使用。
留给读者的问题
你的 Agent 现在有几种找信息的入口?如果其中一条信息已经过期或者被撤回,是哪一层负责让 Agent 知道:搜索服务、向量库、记忆系统,还是 Agent 自己的代码?欢迎在评论区讨论。
参考资料
- [1] Cloudflare, Introducing Web Search API(2026-10-02):https://developers.cloudflare.com/changelog/post/2026-10-02-introducing-web-search-api/;HN 讨论:https://news.ycombinator.com/item?id=49963171
- [2] Google, EmbeddingGemma 2: an open, lightweight multimodal embedding model(2026-10-06):https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/;HN 讨论:https://news.ycombinator.com/item?id=49980487
- [3] 火山引擎, OpenViking v0.5.0 发布说明(2026-10-09):https://github.com/volcengine/OpenViking/releases/tag/v0.5.0
- [4] DeepSeek, DeepSeek Harness dsh-v0.2.1-alpha.2 发布说明(2026-10-09):https://github.com/deepseek-ai/deepseek-harness/releases/tag/dsh-v0.2.1-alpha.2
- [5] Ansuman Mullick, Eray Tüzün, Knowing the Store: What a Memory Backend Must Write Down Before an Agent Can Read It(arXiv:2610.04794,2026-10-03):https://arxiv.org/abs/2610.04794
- [6] Yifei Tao 等, DyadMem: A Long-Term Memory Benchmark of How Agents Work with Users(arXiv:2610.03020,2026-10-02):https://arxiv.org/abs/2610.03020
- [7] Cortrix, Write-Time LLM Inference Gives Every Query More Recall Paths(2026-10-09):https://cortrix.ai/blog/write-time-llm-inference/
- [8] Wikimedia Foundation, OpenAI “rogue” agent activities found on Wikimedia projects(2026-10-05):https://diff.wikimedia.org/2026/10/05/openai-rogue-agent-activities-found-on-wikimedia-projects/;HN 讨论:https://news.ycombinator.com/item?id=49968105