说到 RAG 里的 LLM,大家先想到的往往都是查询的流程:改写问题、给结果排序、生成回答。Cortrix 把其中一部分工作前置到了数据写入流程,在文档写入的时候就进行 LLM 推理前置。这篇我们会剖析 Cortrix 在写入期让 LLM 做了什么,它给检索带来了多少变化,以及什么样的语料值得启用这个特性。
一段文字写入语义存储之前
这里,我们拿客服知识库举个例子。业务场景中退款政策有这样一句:「超过上述期限的申请,按第四条处理。」一般 RAG 会把它单独切成一个块存入数据库,但是当用户问「买了四十天还能退吗」,系统里的这块数据里既没有「四十天」,也没有「退」字,连「上述期限」是多久都不知道。因此,它和问题之间隔了最少两层,它们的说法不一样,上下文也丢失了。
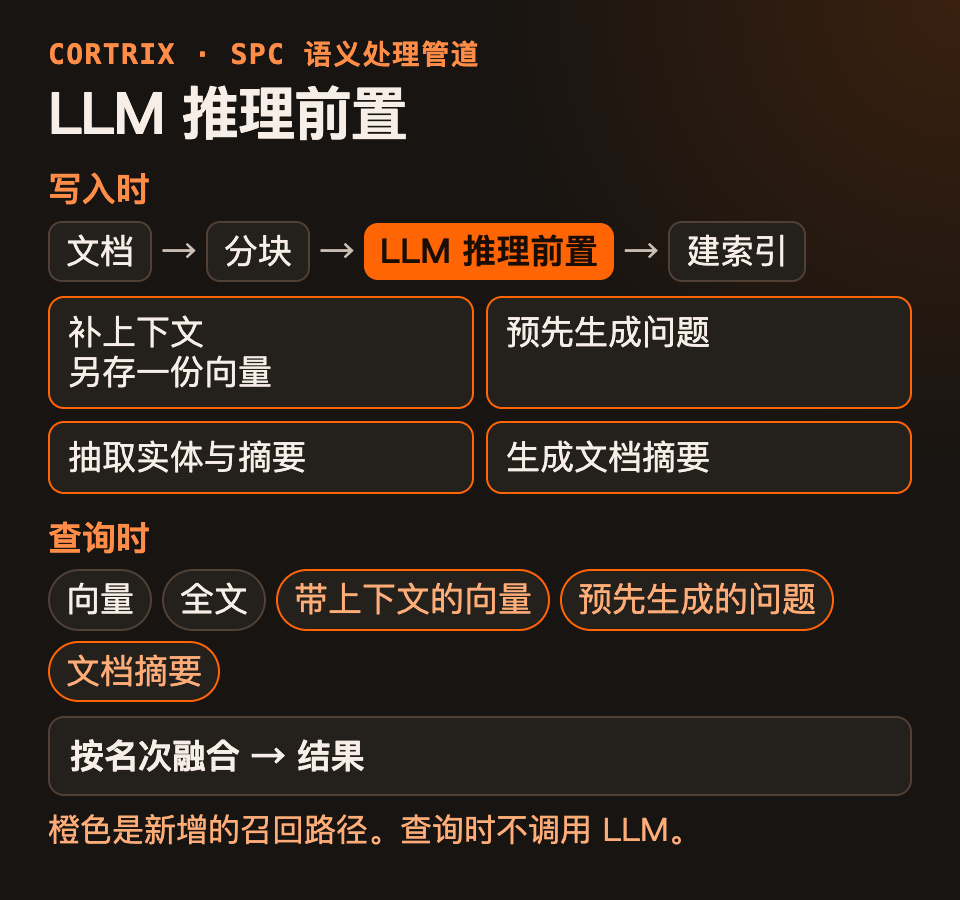
Vector 向量模型能拉近一部分距离,但它只看得到这个数据块本身。而如果让一个读过整篇文档的 LLM 在入库之前先处理一遍,能补上的东西就多了。Cortrix 的写入链路叫 SPC,它是 Semantic Processing Chain(语义处理管道)的简称。配置了 LLM 以后,SPC 在分块和建索引之间会多做几件事:
- 给每个数据块补充一段上下文,说明它在整篇文档里讲的是什么,然后再生成一份向量。原来不带上下文的那份向量也会保留下来,两份并存。
- 替每个数据块预先生成几个用户可能会问的问题,并把这些问题也建进索引。
- 抽取实体,生成内容摘要。
- 给整篇文档生成一份摘要,作为一个可以被检索到的数据块。
这些生成的内容会和原文一起保存在语义存储里。查询的时候,其中三种会各自成为一条召回路径:带上下文的向量和预先生成的问题在数据块这一级,和原有的向量检索、全文检索一起按名次融合,而文档摘要在文档这一级参与融合。抽取的实体和内容摘要不是召回路径,它们用于结果的打分,并且随结果一起返回。因为这些内容在写入时已经生成好了,所以查询的时候不需要为它们再调用 LLM。
下面这个图,画的是 Cortrix 的 LLM 推理前置:文档写入时多做了哪几件事,查询时又多出了哪几条召回路径。
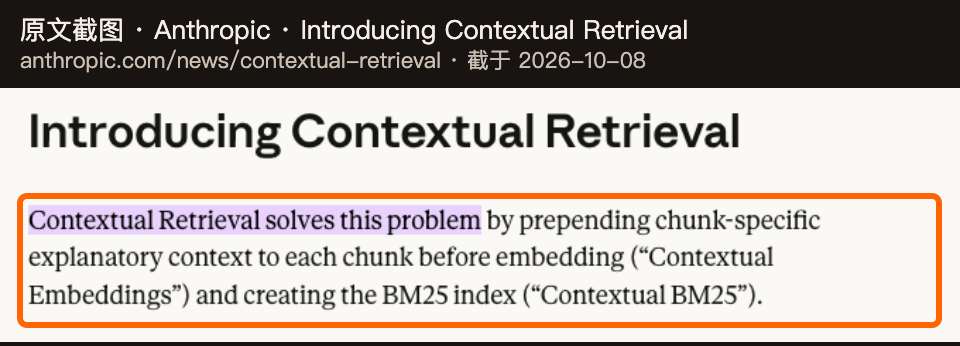
在写入期使用 LLM 这个方向,业界也有不少实践。Anthropic 针对知识库检索提出过 Contextual Retrieval 方法,在入库之前给每个数据块补充上下文。
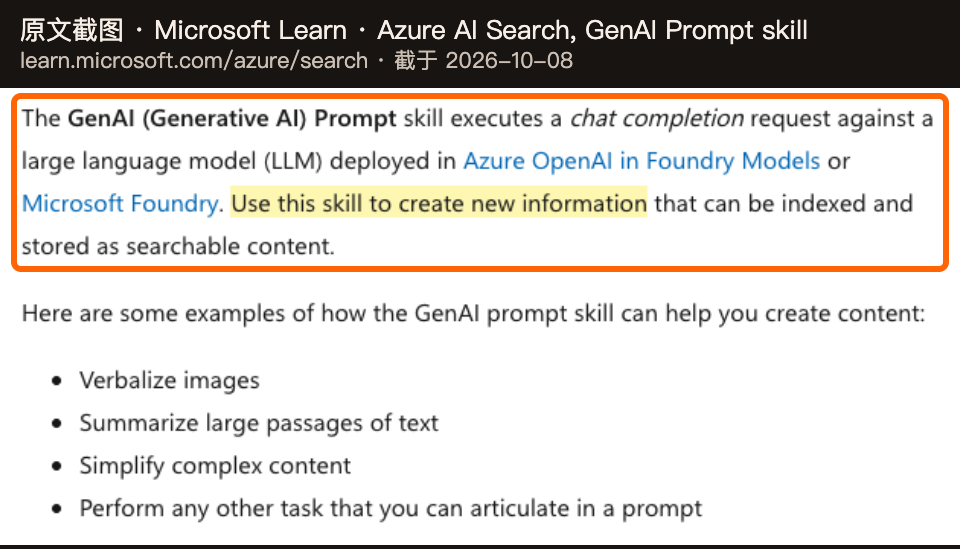
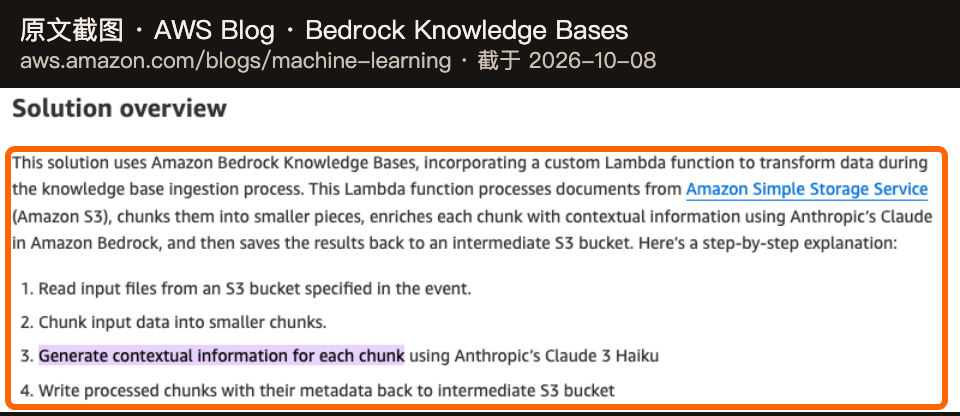
微软的 Azure AI Search 可以在建索引时调用大模型,生成摘要等新内容。AWS 的 Bedrock Knowledge Bases 也可以在入库时挂上自定义函数,来完成同样的事情。
这些做法提供的是一套方法或者一个可以挂接的扩展点,具体怎么生成、怎么把它用于检索,需要使用者自己实现和编排。Cortrix 在这个方向上有自己的做法:几种内容同时生成,其中三种各走一条召回路径,原始向量始终保留。整件事由语义存储的写入链路完成,对接的 Agent 和应用不需要自己编排。
我们实测的效果
下面是公开证据包里两个语料的 nDCG@10,括号里是相对第一列的变化。
| 语料 | 向量加全文 | 加重排 | 再加 LLM 推理前置 | 全栈 |
|---|---|---|---|---|
| SciFact | 0.5942 | 0.6184(+4.1%) | 0.6449(+8.5%) | 0.7784(+31.0%) |
| NFCorpus | 0.2991 | 0.3121(+4.3%) | 0.3124(+4.4%) | 0.3772(+26.1%) |
「全栈」是在 LLM 推理前置的基础上,查询时再让 LLM 对前 30 个候选做一次整体排序。两处使用的是同一个模型 deepseek-v4-flash。所有数字都是在同一硬件配置上测得的,top_k=10。这组数字测于 2026 年 8 月,被测的 Cortrix 核心提交是 79a4eb17,早于 v1.0.0-rc.2。
全栈的效果最明显,SciFact 比基线高出三成,NFCorpus 高出四分之一。
如果只看 LLM 推理前置这一步,SciFact 在重排的基础上又提升了 0.0265,NFCorpus 基本持平。
查询期的重排和写入期的 LLM 推理前置,解决的是两个不同的问题。重排是在已经找回来的候选里调整先后顺序,没有被找回来的内容,它无从排起。LLM 推理前置是在写入时多建了几条召回路径,让原来找不回来的块有机会进入候选。所以两者可以叠加使用,这也是我们目前测到效果最好的配置。
LLM 推理前置,适合处理哪些语料
我们的建议是,先看文档和问题各自长什么样。
如果文档里的数据块离开上下文就读不懂,比如合同条款、政策、技术规范,或者满是「上述」「该项」这类指代的长文档,那么在写入期补充上下文会有帮助。
如果用户的问法和文档的写法差得比较远,那么预先生成问题会有帮助。SciFact 就是这种形状:拿一句科学论断,去找能支持或反驳它的论文摘要,两边的措辞很少会有重合的。
如果文档写一次、查很多次,这一步也更有价值。因为处理只在写入时做一遍,之后的每次查询都会受益。
反过来,如果语料本身就是问答对,或者每一块都自成一体,写入期能补的东西就少,价值也就很低了。
判断自己的语料属于哪一种,不用等到看到总分才来核对。如果你使用的是 Cortrix,我们提供了 ?explain=true 这个查询参数,帮助你直接看到每条召回路径的贡献。你可以拿一批有代表性的业务问题,像下面这样逐个查询:
curl -fsS -H 'Content-Type: application/json' \
  -d '{"namespaces": ["your_namespace"], "query": "买了四十天还能退吗", "top_k": 10, "route": "complex"}' \
  'http://127.0.0.1:8420/api/v1/query?explain=true'
响应里会多出一段 explain,其中的 rrf_path_counts 统计了返回的这些结果分别是由哪些路径排进来的。它一共统计五条数据块级的路径:dense、sparse 和 fts5 是原有的向量和全文路径,contextualized 对应带上下文的向量,hype_question 对应预先生成的问题。它只统计返回的这些结果,不包含文档摘要这条路径。请求里的 route 参数,下一节会讲到。
下面是我们在 v1.0.0-rc.2 上用一篇示例文档实跑这条命令得到的 explain,只保留了相关字段:
{
  "complexity_score": 1.0,
  "query": "买了四十天还能退吗",
  "routing_decision_source": "force_route",
  "routing_path": "complex",
  "rrf_path_counts": { "contextualized": 1, "dense": 1, "hype_question": 1 },
  "via_path_counts": { "hybrid": 1 }
}
返回的这条结果同时被三条路径排了进来:原有的 dense,以及写入期新增的 contextualized 和 hype_question。同一个问题不带 route 参数再查一次,这条查询被判为 simple,rrf_path_counts 里就只剩下 dense。
如果新增的路径经常出现,说明 LLM 推理前置生成的内容正在起作用。如果很少出现,这类语料就可以先不启用。
如果你的业务追求更高的检索质量,除了 LLM 推理前置,还可以再加上查询期的 LLM 重排,也就是 Cortrix 的全栈操作。查询期的重排需要另外配置 semantic_llm 这个角色。
在 Cortrix 里怎么启用
Quickstart 默认不启用任何 LLM,只用本地的向量和重排模型就能跑通检索。LLM 推理前置用到的 LLM 按角色配置,enricher_llm 负责富化,doc_summary_llm 负责文档摘要:
enricher_llm:
  provider: "openai"
  api_key: "your-api-key"
  model: "your-model"
  base_url: "https://your-endpoint/v1"

doc_summary_llm:
  provider: "openai"
  api_key: "your-api-key"
  model: "your-model"
  base_url: "https://your-endpoint/v1"
每个角色只要把 provider、api_key、model 填齐,就算配置完成,没有填的角色保持关闭。服务端使用的是 OpenAI 兼容协议,所以对接本地的模型网关也可以。
Cortrix 收到查询后,会先判断它的复杂度,分成 simple、complex、chat 三档。这三档用到的写入期内容并不一样。complex 这一档会把带上下文的向量和预先生成的问题一起纳入融合。simple 这一档只使用原始的数据块向量和全文路径,这两条新增的路径不会参与;而文档摘要是按检索粒度参与的,在默认的粒度下,它在 simple 档也会参与融合。chat 这一档不检索数据块,它走的是只查记忆的路径。响应的 explain 里有一个 routing_path 字段,告诉你这次查询实际走的是哪一档。如果想让查询固定走完整的路径,可以在请求里加上 "route": "complex",上面的实测里除了第一列基线以外,都是这样做的。完整的请求参数可以对照公开 runner 里的 profile。启用之前,建议先看一遍 v1.0.0-rc.2 的发布说明。
用 Cortrix 还是自己 Glue code
如果你不是使用 Cortrix 作为 Agent 的语义存储(Semantic Storage),我们也欢迎你参考 Cortrix 的源码,它以 Apache-2.0 协议开源。想要在自己现有的数据架构里实现 LLM 推理前置,下面这四个问题必须处理好:
- 带上下文的向量和原始向量要同时保留下来。有两个不同的路径一起参与,当新的一路效果不好时,原来的一路还能作为保底。
- 生成的内容要跟着原文走。原文更新或删除的时候,补充的上下文、预先生成的问题、内容摘要都要跟着重做或清理,否则检索会命中那些已经不存在的内容。
- LLM 调用失败时,不能对写入造成堵塞。文档应该先按没有 LLM 的方式入库,之后再补 LLM 处理。
- 整个
LLM 推理前置过程要能看到每条召回路径各自的贡献。只看总分无法分清是哪一路在起作用,导致对接的 Agent 无法做后续的业务判断。
这四件事各自都要写 “Glue code(胶水代码)”,之后还要作为独立的模块长期维护。如果你不想手搓这些代码,也不想在未来给自己管理增加工作量,那就还是直接使用 Cortrix 吧。让自己专注于处理业务工作,把复杂的数据管理交给我们。其中这几项已经在 Cortrix 里:两份向量并存,富化有预算上限和降级,LLM 不可用时文档摘要退回到文本匹配,每次查询都可以用 explain 看到各条路径的贡献。
常见问题
LLM 推理前置是什么
LLM 推理前置是 Cortrix 语义存储的一个特性:在文档写入的时候,由 LLM 给每个数据块补充上下文、预先生成用户可能会问的问题、抽取实体和摘要,并生成文档摘要。其中带上下文的向量、预先生成的问题和文档摘要,在查询时各自成为一条召回路径。
启用 LLM 推理前置之后,查询时还需要调用 LLM 吗
不需要。这些内容在写入时已经生成并保存在语义存储里,查询时只做召回和融合。如果你还想进一步提高检索质量,可以再加上查询期的 LLM 重排(需要配置 semantic_llm),也就是 Cortrix 的全栈配置。
哪些语料适合启用 LLM 推理前置
数据块离开上下文就读不懂的文档,比如合同条款、政策和技术规范,以及用户的问法和文档的写法差得比较远的语料。如果语料本身就是问答对,或者每个数据块都自成一体,启用的价值就比较低。
参考
-
Cortrix GitHub 仓库:https://github.com/cortrix/cortrix
-
Cortrix Quickstart:https://cortrix.ai/docs/get-started/quickstart/
-
四语料 CPU 证据包,固定到提交
4b94390c:https://github.com/cortrix/cortrix-benchmarks/tree/4b94390c1d5f7be95065e7483362ec7f93774ed7/results/published/beir-four-corpus-cpu-2026-08-v1 -
公开 runner 的 profile 定义:https://github.com/cortrix/cortrix-benchmarks/blob/9490520c24a96ed97b80073ed3ebab096b80550b/benchmarks/beir-retrieval-quality/runner/profiles.py
-
Cortrix feature index:https://github.com/cortrix/cortrix/blob/main/docs/feature-index.md
-
Anthropic, Introducing Contextual Retrieval(2024-09-19):https://www.anthropic.com/engineering/contextual-retrieval
-
Microsoft Learn, GenAI Prompt skill(2026-07-28):https://learn.microsoft.com/en-us/azure/search/cognitive-search-skill-genai-prompt
-
AWS Machine Learning Blog, Contextual retrieval in Anthropic using Amazon Bedrock Knowledge Bases(2025-06-05):https://aws.amazon.com/blogs/machine-learning/contextual-retrieval-in-anthropic-using-amazon-bedrock-knowledge-bases/
这组测量看的是 top_k=10 下两个语料的检索质量,用来说明方向,不是 Cortrix 和其他产品之间的比较。本文讲的行为对应 Cortrix v1.0.0-rc.2,这是一个预发布版本;表中的数字测于 2026 年 8 月的核心提交 79a4eb17。