上一篇文章里,我解释了为什么我们当前不会把 Jev 或 Laya 加入 Cortrix 的内核。
我们认为 Jev 和 Laya 不适合负责从 Semantic Storage 这种长期保存语义数据的基础存储平台查找候选内容。但是,如果它们拿到的是已经整理好的状态和目标选项的结果数据,那它们就可以发挥其优势,做快速决策判断。
检索和判断是两件不同的事,把一个判断模型塞进 storage,不会让 storage 自动理解业务。但换一个位置,让它们用在调用 Cortrix 处理具体业务的 Agent 上,Jev 和 Laya 就可以变得很有意思了。
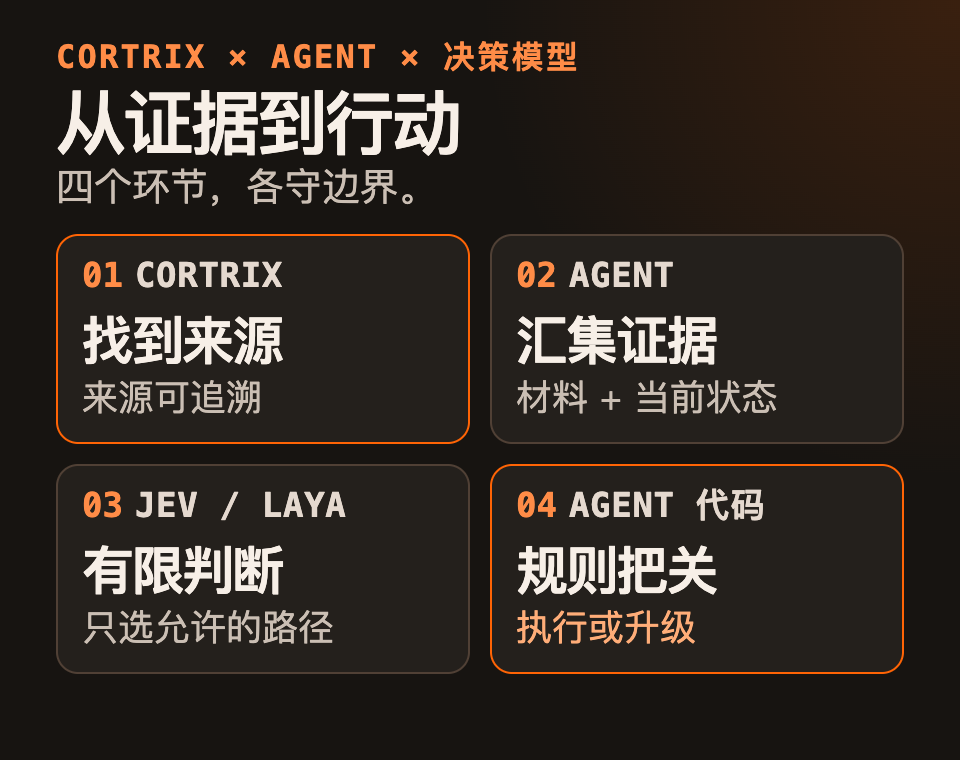
下面这个图,我模拟了这条 Agent 流程。
Cortrix 先完成检索,Agent 再把检索结果与业务系统提供的来源、状态等整理成一份证据输入。然后,决定证据是否足够,验证几份材料会不会互相冲突,如果有问题是应该再找一次、换一条路径,还是直接交给人。这些环节 Jev 和 Laya 都可以发挥作用。
这些动作并不需要再生成一段新的答案,它们只需要一个范围明确的判断。
退款没到账,咋办?
我们假设一个场景:今天客户又找到客服,说他上周已经收到“退款已处理”的答复,但钱就是没有到账。现在他很生气要求立即解决,不然就把事情升级投诉,向媒体曝光。
这可就不是一个单纯的客服问题。相关信息散在好多地方:
- 上一次客服对客户作出了什么承诺?
- 订单系统里的退款状态正确吗?
- 财务系统有没有实际的付款记录?
- 客户购买时包含哪些退款规则?
- 后续规则有哪些调整,是否为例外处理先例?
- 同类问题此前有哪些可参考的处理记录?
Agent 先基于 Semantic 语义检索,通过 Cortrix 找到相关材料,再把检索结果与客服、订单、财务和规则系统提供的当前状态整理成一份证据。每条材料是什么、从哪里来、发生的时间、与当前问题有什么关系,分别由检索结果和这些业务记录提供,Agent 把它们组织到同一个上下文里。
然后,冲突出现了。
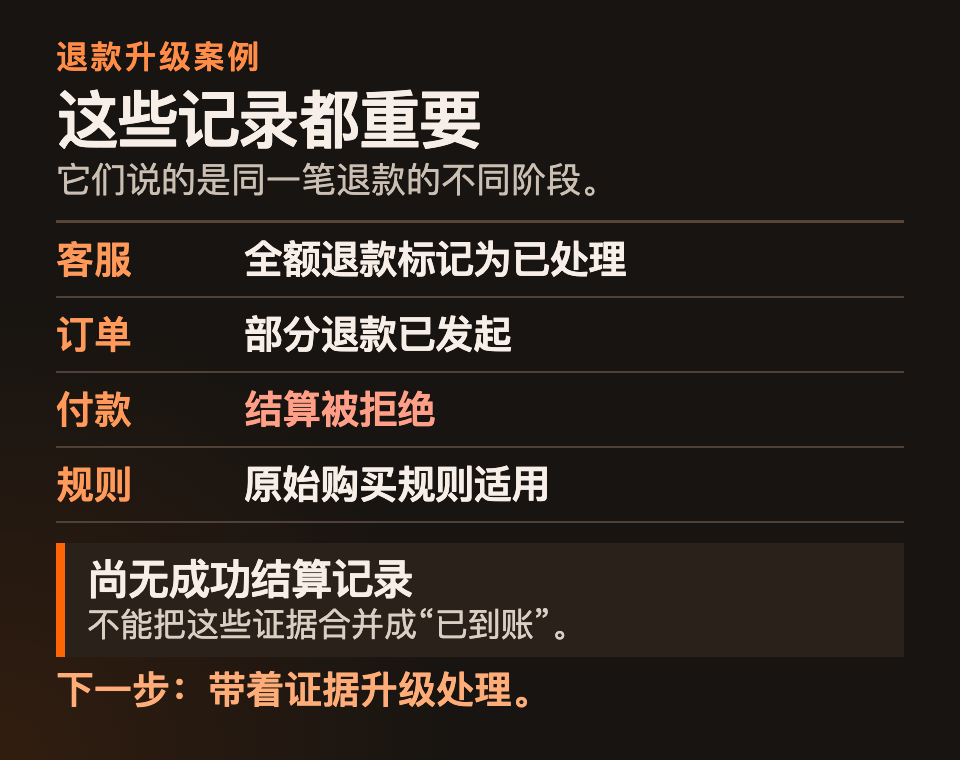
客服记录写着“全额退款已经处理”,而订单系统显示“部分退款已发起”,再看财务记录却显示付款渠道拒绝了这笔交易。也就是说,业务确实已经进入处理过程了,每条都没有出错,只是它们描述的不是同一个阶段。
如果 Agent 只拿其中一条生成回复,它很容易再次告诉客户“已经处理”。这句话在客服记录里有依据,但放在真实业务结果上却是错的。
Cortrix 的工作是检索相关材料。Agent 把材料与业务系统里的当前状态组织成证据输入,这时候使用 Jev 或 Laya 基于这份输入之上帮助 Agent 做下一步判断才真正发挥出它们的作用。
前提条件:证据要充分
Agent 不应该把“搜到了内容”直接理解成“可以回答”。
如果我来设计对于这笔退款的数据结构,大概可以这样设计:
state:
  customer_promise: full_refund_processed
  order_status: partial_refund_started
  payment_status: rejected_by_channel
  applicable_policy: original_purchase_policy

decision:
  - evidence_is_sufficient
  - more_finance_evidence_needed
  - policy_owner_review_needed
  - human_escalation_required
Jev 或 Laya 接收的不是“请解决客户 xx 问题”这种开放任务。它收到的应该是 Agent 根据 Cortrix 检索结果和业务系统状态整理后的内容,以及 Agent 当前被允许选择的那几条路径。
这个区别很重要。decision model 可以认为证据不足,但它不能自己创造一条付款记录。它可以建议升级到其他处理级别,但前提是你给了它选项,它不能因为答案的自信度很高就自己批准一笔新赔付。
证据、权限和业务事实仍然留在原来的系统里。
冲突应该被标记,不应该被删掉
很多 RAG pipeline 喜欢在最后只留下一个最相关答案。对于业务事故,这个习惯很危险。
客服承诺、订单状态和付款失败并不是三个互相替代的答案。它们共同描述了退款从承诺到执行再到失败的完整过程。删掉任何一条,Agent 都可能得到片面的故事描述。
Jev 或 Laya 更适合给候选增加标记:
support:
  - customer was promised a full refund

conflict:
  - order status says partial refund
  - payment status says rejected

missing:
  - no successful settlement record
这样的标记可以帮助 Agent 组织下一步工作,但 Agent 组装的原始证据会继续保留。decision model 的判断是一层注释,而不应该是删除其他证据的动作。
这也是像 Cortrix 这样的 Semantic 数据层 与 decision 层的边界。Cortrix 负责检索相关材料,Agent 在证据输入中保留来源信息;Jev 或 Laya 判断这些证据对当前动作意味着什么。所以,任何时候 Agent 都依然可以回到源头进行检查,而不是只看到模型替它筛选后的“二手信息”。
退款失败,Agent 下一步怎么选?
继续前面的假设,这时退款 Agent 再次查询付款渠道,结果仍然是拒绝。接下来有几条路:
choice:
  - retry_same_channel
  - use_authorized_fallback
  - ask_finance_owner
  - escalate_to_human
这里适合使用 typed decision,因为候选路径已经由业务流程和权限系统确定。Jev 或 Laya 只负责在现有状态下判断哪条更合适。代码继续负责硬约束:同一渠道最多重试几次,备用路径是否对这笔订单开放,什么金额必须人工批准,等等……
模型,负责处理模糊判断。代码,负责守住那些不能模糊的边界。
成本节约需要看全链路
一次调用成本很低,不等于整条 Agent 链路成本都可以节约。我们可以看到 Jev 可以轻量化调用,Laya 更加可以本地化部署。但是如果 Agent 已经完成多轮检索、调用了LLM模型、并已经写完回复信息,最后才接入 Jev 判断这份回复能不能使用。这样的流程下,成本最高的工作早就发生了。
真正有价值的接点在前面:
- 在生成客户回复以前,判断证据是否充分。
- 在重复查询同一个系统以前,判断是否应该换路。
- 在进入自动赔付以前,标记冲突并切到人工审批。
- 在运行更多富化以前,判断当前缺少的到底是哪一类证据。
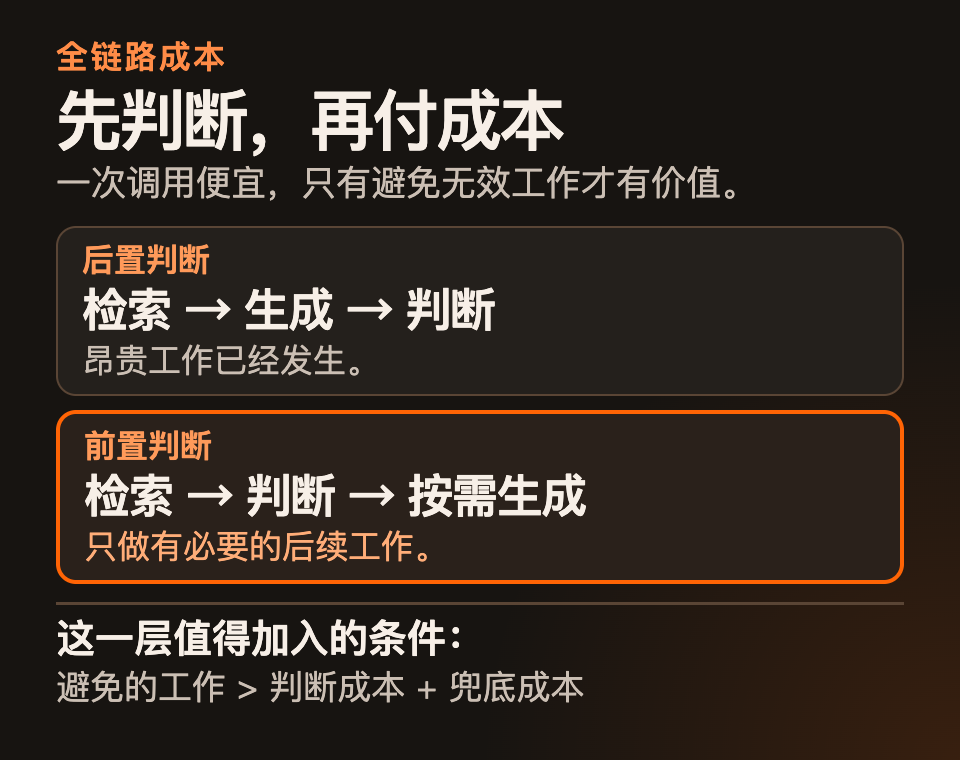
只有 decision cost 加上 fallback cost,小于它真正避免的工作量,才能证明这一层对系统产生收益。
这里的收益也不只是一张 API 账单。无效的重试会消耗客户耐心,选择了错误路径会增加返工的可能性,过早生成会把冲突证据包装成一段听起来很确定的回复,而证据其实并不充分。Agent 少走一个错误的回合,正确地处理业务,比节省 token 更重要。
Jev 和 Laya 对应两种运行边界
Jev 和 Laya 可以放在同一个 DecisionProvider 接口后面,但它们代表不同的运行方式。
Jev 是托管路径。Agent 把整理好的状态和候选发送给服务,再接收 choice、score 或其他 typed decision。团队不需要运行模型,但网络、服务可用性和数据边界进入了整个系统。
Laya 是本地开放权重路径。团队可以把证据输入留在自己的环境里,也可以自己管理推理资源、版本和 fallback。与此同时,模型加载、运行成本、语言表现和维护也都由自己承担。
Cortrix 不需要替 Agent 固定其中一个。
更自然的接口是:Agent 把 Cortrix 检索所得到的结果与业务系统状态组织成一份稳定的证据,再根据自己的延迟、隐私、成本和运维边界,选择 Jev、Laya、普通规则或生成模型。
同一个业务状态可以交给不同 provider,但它们必须看到同一批证据、同一组选项,并接受同一套权限约束。这样 decision layer 才是可以替换的组件,而不是藏在 Agent 里的另一套业务事实。
Jev 和 Laya 如何与 Cortrix 形成上下游生态
Cortrix 要解决的是 Agent 怎样从长期保存的信息里找到与当前问题相关的材料,并保留回到来源检查的路径。
Jev 和 Laya 要解决的是 Agent 拿到状态以后,怎样快速完成一个有限判断。
二者之间可以形成一条很清楚的接缝:
Cortrix retrieval results
        +
business system state
        ↓
Agent-built evidence input
        ↓
DecisionProvider
  Jev / Laya / rules / LLM
        ↓
Agent policy and state machine
        ↓
business action or human review
Cortrix 不替业务系统批准动作。Jev 或 Laya 不替 Cortrix 找回没有召回的事实。Agent 也不会把概率当成可执行的权限。这样,普通代码就可以变得更简洁,它们把控业务边界,但不再需要把业务里所有模糊判断重新写成越来越长的 if 语句。
上一篇文章讨论的是为什么 Jev 和 Laya 不适合进入 Cortrix 内核。
这篇文章讨论的是它们离开内核以后,应该放在哪里。
Jev 或 Laya 的位置应该在 Agent 拿到 Cortrix 检索结果并组织好证据输入以后,在 Agent 真正采取行动之前。
公开参考: