Jev 和第三方开源的同类模型 Laya 这周被吹上天了。但分析架构以后,我们决定当前不引入 Jev,也不启动 Laya 的验证。
Jev 适合做系统中小而明确的判断。你给它一段状态,再给它几个选项,它可以给你返回 Choice、Score 或布尔结果,和相应的概率。我们可以考虑在工具选择、查询路由、是否重试、候选评分等场景使用 Jev。
但 Cortrix 当前要解决的不是这个问题。我们要做的是面向 Agent 的 Semantic Storage。需要它把持续写入的内容有效地组织起来,在 Agent 查询的时候从数据中找出可能相关的内容,再把结果、来源、上下文和检索过程一起返回给 Agent。
这里最先发生的动作不是“从几个答案里选一个”,而是“哪些内容应该进入候选集”。
所以,我们没有因为 Jev 本周的大热,就把它硬塞到 Cortrix 检索的核心。
Jev 自己也清晰地说明了边界
TypeSafe 把 Jev 定义为 System One 模型:输入非结构化状态,输出带类型和概率的判断,不生成文本。Jev 不生成向量,不提供查询改写能力,也不会形成摘要或返回其他结果内容。
一个语义检索系统必须先产生候选集,通过向量索引、稀疏索引、关键词检索、文档发现和查询扩展都可能把一份原本看不见的文档带进候选集。Jev 可以对这个候选打分,但它不能凭一次对候选集的判断,把库里另一份没有出现在候选集的文档重新找回来(也就是无法处理召回的问题)。
这里用一个集合公式写出来,可能就更清晰了。原始候选是 C_N,最后返回的是 S_k。如果 Jev 只参与重排,那么 S_k ⊆ C_N。排序可以改变前十名,但不能突破候选集的召回上限。
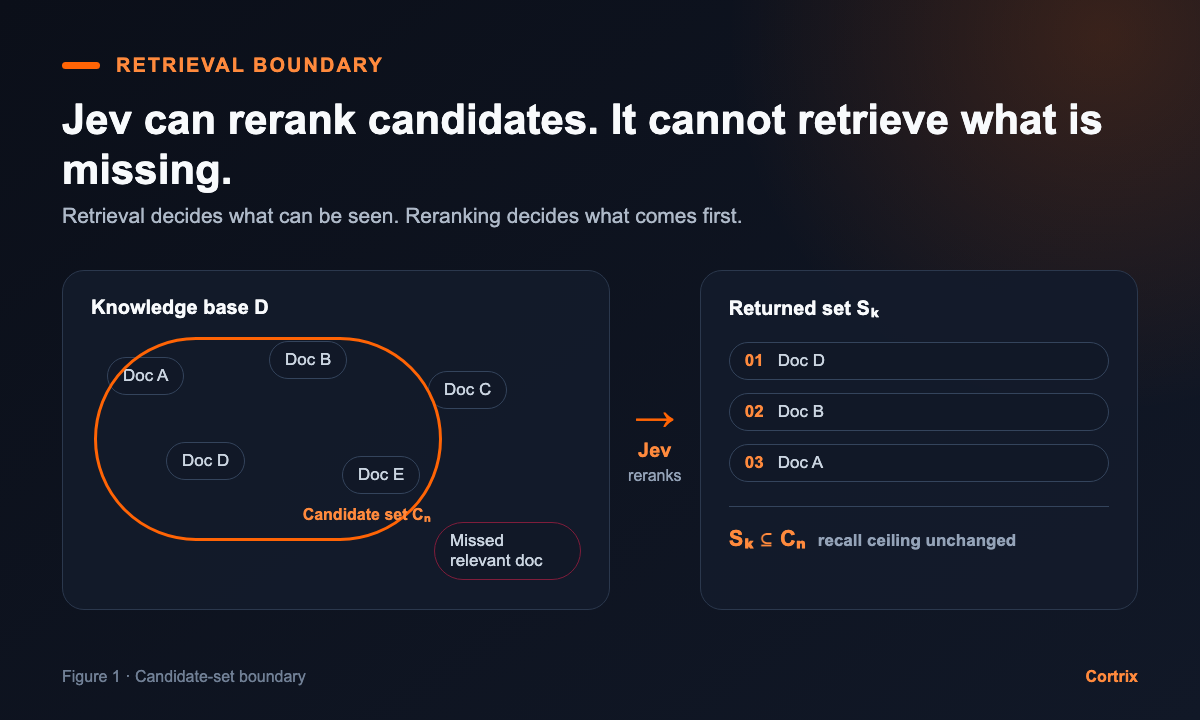
图 1:召回决定哪些文档进入 C_N。Jev 可以改变候选集内部的顺序,但不能找回召回阶段漏掉的相关文档。
我们也核对了 Jev 最接近检索的公开结果
TypeSafe 的重排示例使用 40 条 CLERC 查询和 3,565 个 passage。BM25 先对每条查询取出 30 个候选,Jev 再对这些候选进行评分。这个公开的报告显示 top-10 accuracy 从大约 38% 提高到 62%。
认真地看这个结果我们可以发现,它可以证明 Jev 是一个有效的候选信息判断模型。但是它不提供召回的能力,也没有证据证明它会优于 Cortrix 当前使用的本地 BGE 处理方法。第三方开源的同类模型 Laya 当前也没有足够的公开数据支持这样的判断。
第三方公开评测也没有给出直接替换的理由。jev-search-rerank-eval 使用 164 条中英混合查询和 9,831 对标注数据,让 Jev 直接重排 bge-m3 的 top-30,NDCG@10 只增加 0.012,95% 置信区间从 -0.013 到 +0.037,跨过零;只看与 Jev 无关的 LLM 标注时,结果变成 -0.028。另一项 jev-orderby-bench 在 Amazon ESCI hard probe 上有 6 项门禁失败 4 项。这些都不是 Cortrix 实测,但至少说明 Jev 并不是可以直接替换现有重排的免费收益。
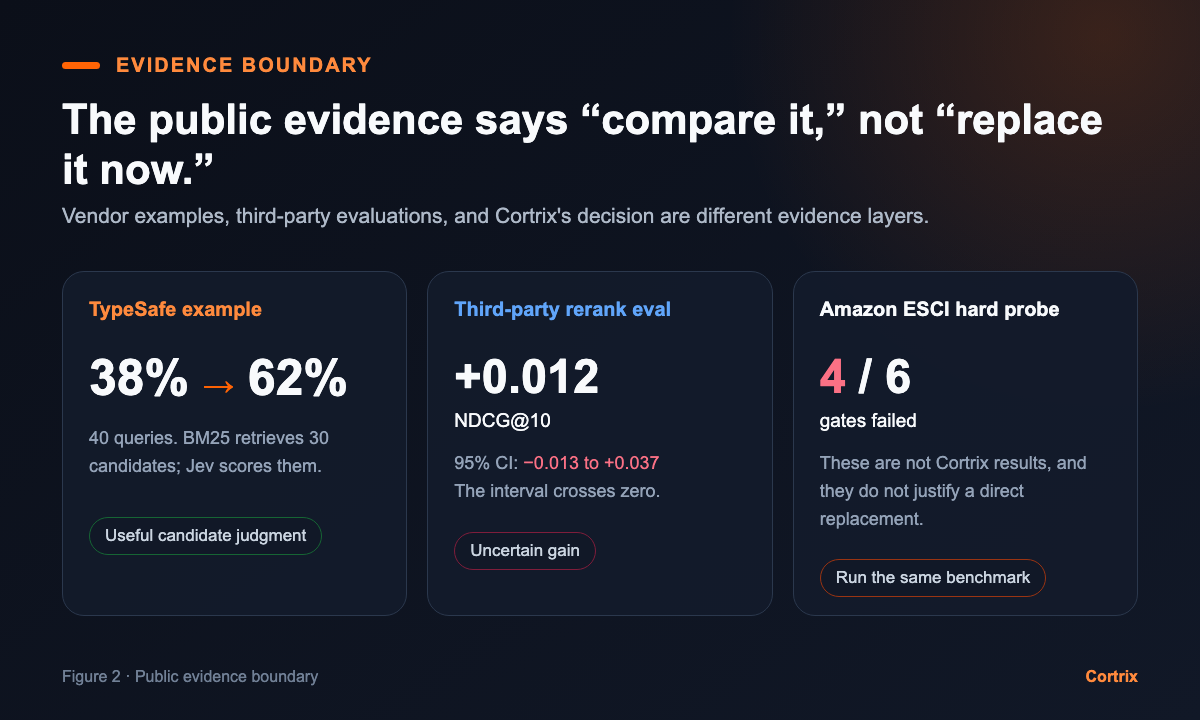
图 2:公开证据支持把 Jev 放进同台比较,但不足以支持在没有相同候选集 benchmark 的情况下直接替换当前路径。
我们也从成本角度进行了拆解。官方文档给出的限额是每分钟 1,200 个请求。如果按一次查询需要判断 20 个候选来计算,理论上需要消耗 20 个请求;不计路由、重试和其他租户,吞吐上限约为每秒一个业务查询。如果有多个候选塞进一次请求可以减少请求数,但这也会改变上下文长度和评分一致性,需要单独测试。
能否“节省成本”,要全链路分析
Jev 的输入价格很低,返回的又是结构化结果。对于系统需要从少量结果集形成判断的场景,确实是很有吸引力的。但 Cortrix 要看的不是一次 API 调用的价格,而是整条链路的成本。这里包括:Jev 调用、生成模型、网络和日志、失败后的重试和降级、判断结果的校准,等等……
如果 Jev 可以在调用生成模型之前,判断这次任务根本不需要生成,那么它有可能帮助我们节省一次更贵的调用。但是,如果内容已经生成完了,再让 Jev 决定是否丢弃。这时候 LLM 费用已经发生了,Jev 最多只能节省后面的 embedding、索引或处理成本(能节省的很有限)。
另一个角度,如果 Jev 替换的是一次昂贵的 LLM 判断,那也对我们会很有帮助。但是,实际上它替换的是一个已经很快的本地规则,而由此会产生的新增的网络请求和延迟,反而可能让系统更慢。
所以,更低的 token 单价并不能直接和更低的系统成本画上等号。
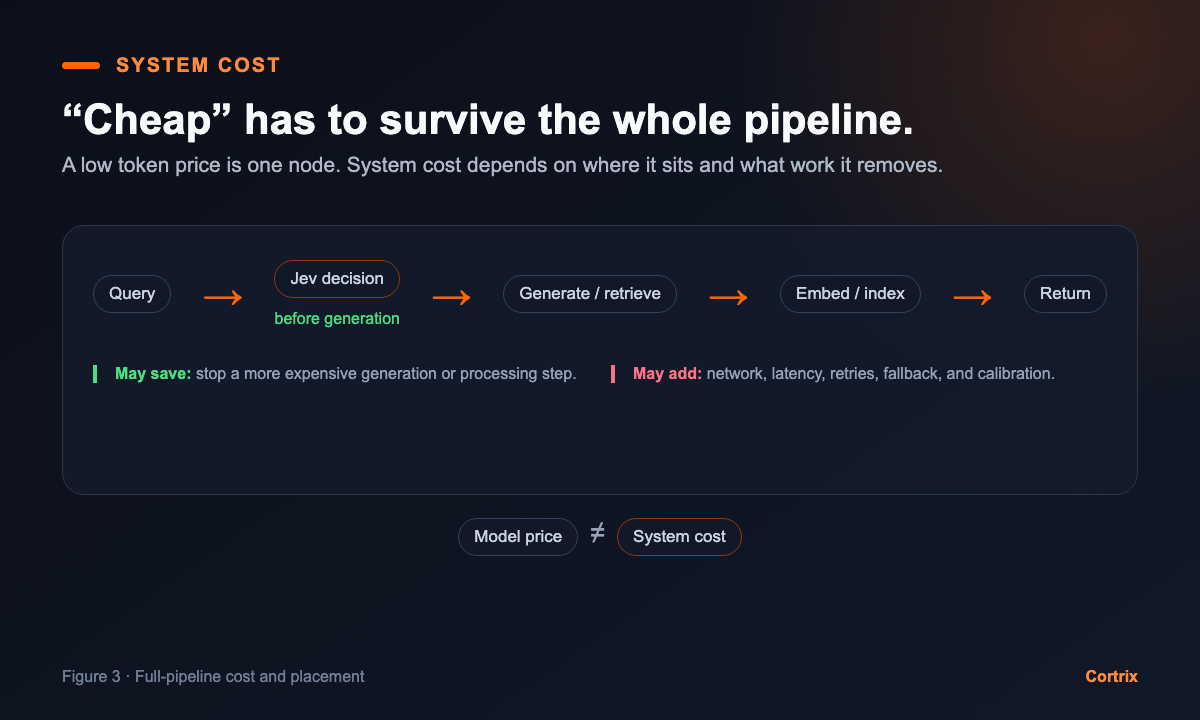
图 3:模型单价只是系统成本的一部分。只有判断所减少的后续工作足以覆盖网络、延迟、重试、降级和校准成本,整个系统才会真正更便宜。
Cortrix 怎么判断要不要引入 Jev
我们逐项检查了已有的 embedding、cross-encoder 重排、查询复杂度路由、检索结果判别和记忆抽取。
对于要不要接入 Jev,得到了三个自己的结论:
-
第一,embedding 不能替换。Jev 不输出向量,无法承担索引和近邻召回。
-
第二,现有本地重排没有替换证据。公开结果支持“值得比较”,不支持“现在换掉”。要作替换,至少需要在同一候选集上比较 BGE 和 Jev 的 NDCG、Recall@k、p95 延迟、吞吐、失败回退和总体成本。(或许我们下一轮 benchmark 可以加入再进行验证)
-
第三,Jev 对有限结果集的判断是有价值的。在路由、证据标记、富化门控或记忆候选筛选方面,它或许是一个可以考虑的方案。但我们需要把它放在真正可以减少后续处理的位置。例如在生成之前判断是否需要继续,而不是内容已经生成以后再做一次筛选。对于低置信结果、请求超时或服务不可用的情况,也必须继续走原有路径,不能因为增加了 Jev,就让一次判断失败直接变成内容漏检。
我承认,我们只做了框架适配的调研,没有实测。我们先看 Jev 的接口能提供什么能力,再分析它能否改变候选集,然后按 Jev 文档计算调用和吞吐,最后对照现有组件的输入输出要求。各项结果都不能证明 Jev 可以给 Cortrix 带来明显的提升。
Jev 确实是个大热的话题,也为模型技术提出了一个值得关注的新方向。但我们这次的结论很明确:当前不会把 Jev 引入 Cortrix,也不启动 Laya 的验证。
以后如果要重新评估,我们会把它加入同一组 benchmark,在相同候选集上和 BGE、现有重排方法比较质量、延迟、吞吐和总体成本。只有这些结果证明它真的改善了 Cortrix 的检索链路,我们才会考虑引入。
Cortrix 当前要先解决的,仍然是怎样为 Agent 找到正确的内容,并把来源、上下文和检索过程一起交给它。这件事情没有因为 Jev 本周的大热而发生变化。