删除 是一个 Agent 记忆里较少被讨论的动作。这一周,和 Semantic 语义技术有关的几件事,都谈到了它。Tiger Data 的 pg_vectorsearch 把 删除 当成存储问题:被删的行先变成墓碑,要重建索引才回收空间。Zep v4 关心来历,知道一条事实从哪里来,才知道该删什么。OceanBase 开源的 PowerContext 把遗忘做成停用,记忆不再被使用,正文和历史留着备查。由清华大学和新浪微博提出的 Bemula 基准,则站在用户这一边,测用户说了「忘掉」之后系统到底做到没有。可以看到,存储、来历、生命周期、用户的要求,删除 至少牵涉这四层。
本文的互动数是 2026-10-17 的公开快照,会随时间变化。论文里的数字是作者自己的实验结果,厂商的说法按其自述引用。
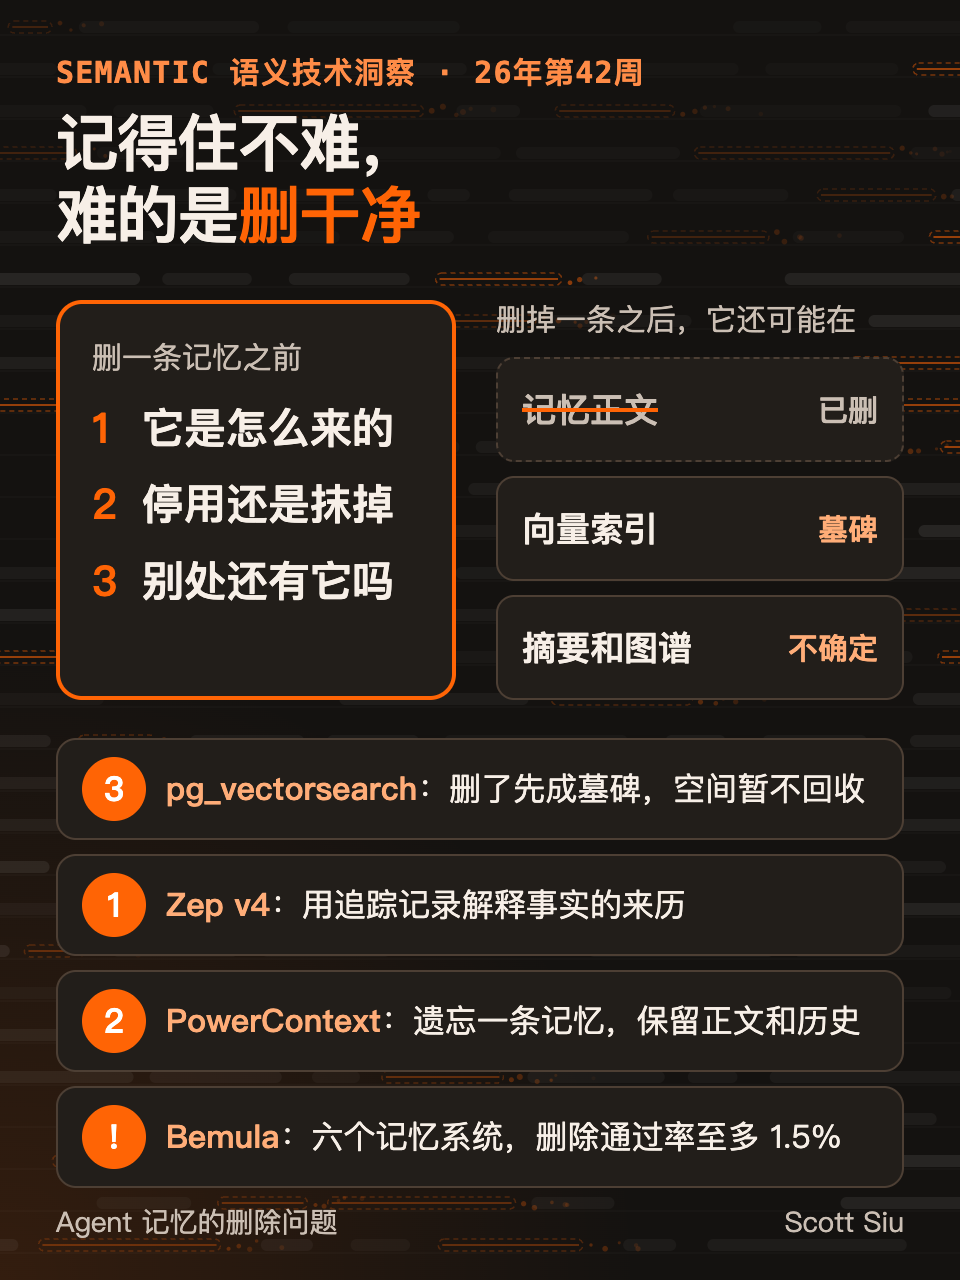
图 1|本周的主线:记得住不难,难的是删干净。
向量索引:删掉的行,先变成墓碑
Tiger Data(原 Timescale)在 10 月 13 日发布了 pg_vectorsearch 0.1.0,这是一个开源的 PostgreSQL 向量检索扩展,当前是 alpha 版。它的 PRISM 索引用分区加压缩代替 HNSW 的图结构,可以直接建在 pgvector 已有的向量列上,使用 PostgreSQL 开源协议。Tiger Data 用自己的开源测试工具测出:在 1 亿条向量、128 GiB 内存的机器上,PRISM 用 1 小时 40 分钟建完索引,在 99% 召回率下查询耗时 21 毫秒,同样的机器上 HNSW 没能建完。这个新闻在 Hacker News 上拿到了 208 points 和 52 条评论。
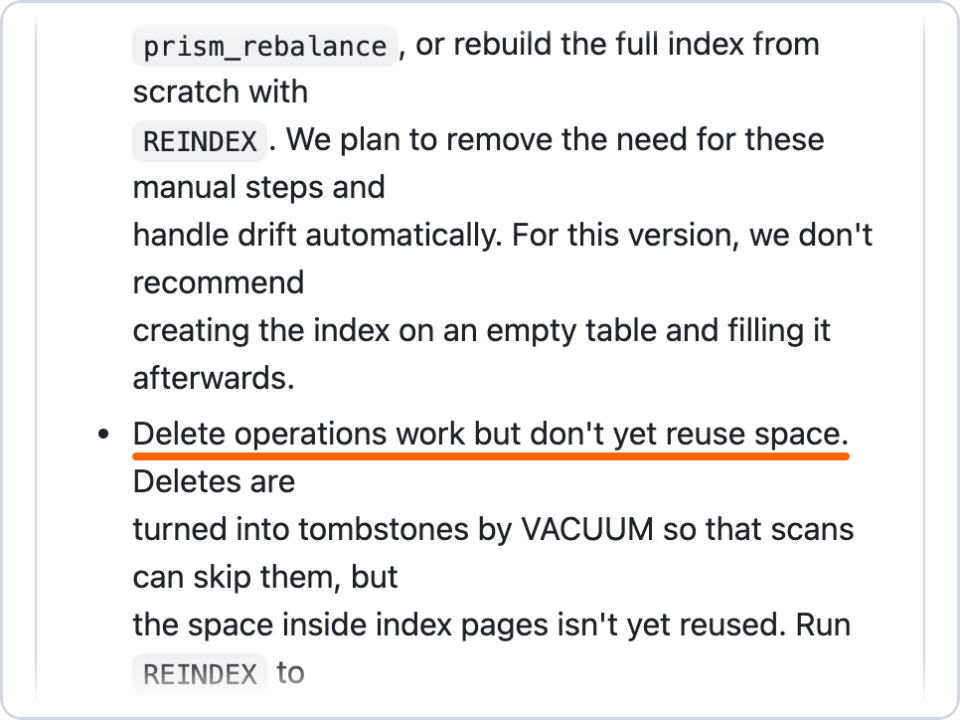
图 2|pg_vectorsearch 0.1.0 的发布说明,截于 2026-10-17。见参考资料 [1]
【S评】性能是最容易引人关注的标准,Tiger Data 也用性能作为标题。而这次发布吸引我的地方,反倒是它对不足之处的坦白。当中提到,删除 后空间暂时不回收:被删除的行由 VACUUM 变成不可用的标记(墓碑 tombstones),扫描时会跳过,需要通过 REINDEX 回收空间。频繁的插入和更新可能会让召回率慢慢漂移,要手动再平衡。另外,还有一条很容易被忽略的信息:排序扫描能返回的行数,受一块缓冲区域的限制,超出的部分就会被截掉,不报任何错误(为什么要这样设计,我暂时还无法理解)。第一版就把这些写在发布说明里,是很老实的做法。它也提醒我们,对 Agent 来说「删了」和「查不到了」不是一回事,中间还隔着一层索引。
记忆平台:必须先说清楚每条事实是怎么来的
Zep 在 10 月 14 日发布了 v4,官方的定位是「为调用它的 Agent 设计的 Context API」。这一版新增了 Ingestion Traces:打开调试以后,记录被追踪的抽取步骤的输入、输出和错误(Flex 及以上档位提供),用来解释一条错误的事实是怎么被写进系统的。另外几项值得关注的变化是:
-
reference_time:记录事件实际发生的时间,这是一个单独的标记,和 Zep 收到数据的时间分开; -
超边(Hyperedge):把涉及三个以上实体的一条事实存成一个整体;
-
子图:展开碰到节点或边的上限时,响应里会标明结果被截断,并写明碰到了哪个上限。
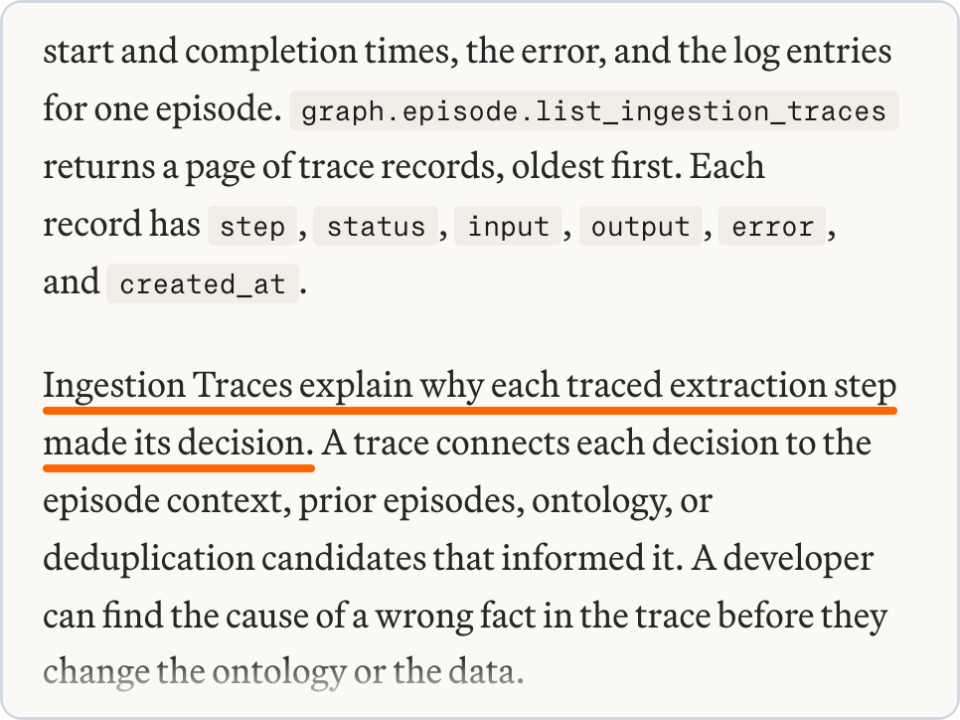
图 3|Zep 介绍 v4 的博客,截于 2026-10-17。见参考资料 [2]
【S评】要删掉一条错的记忆,前提是要知道它从哪里来,以及经过哪些抽取过程进入系统,否则只能删掉表面看见的那一条记忆,而它派生出来的东西会持续残留。Zep 这次把「为什么会有这条事实」做成了可以查询的记录,我认为这比任何检索速度的提升都更重要。
记忆生命周期:遗忘,不等于抹掉
OceanBase 开源的 PowerContext(仓库原名 powermem)在 10 月 12 日发布了 v1.3.0。这一版把每条事实、偏好或决策存成一条独立的原子记忆,各自保留不可变的正文版本、精确的证据引用和生命周期。发布信息里提到:遗忘一条记忆时会保留正文和历史,之后还能恢复;只有已退役的记忆不能直接恢复。它还在数据写入前加了一个可以调的档位,分关闭、只记录、提示、拦截四档,启用后默认只记录判断、不拦截写入,也不调用外部模型。
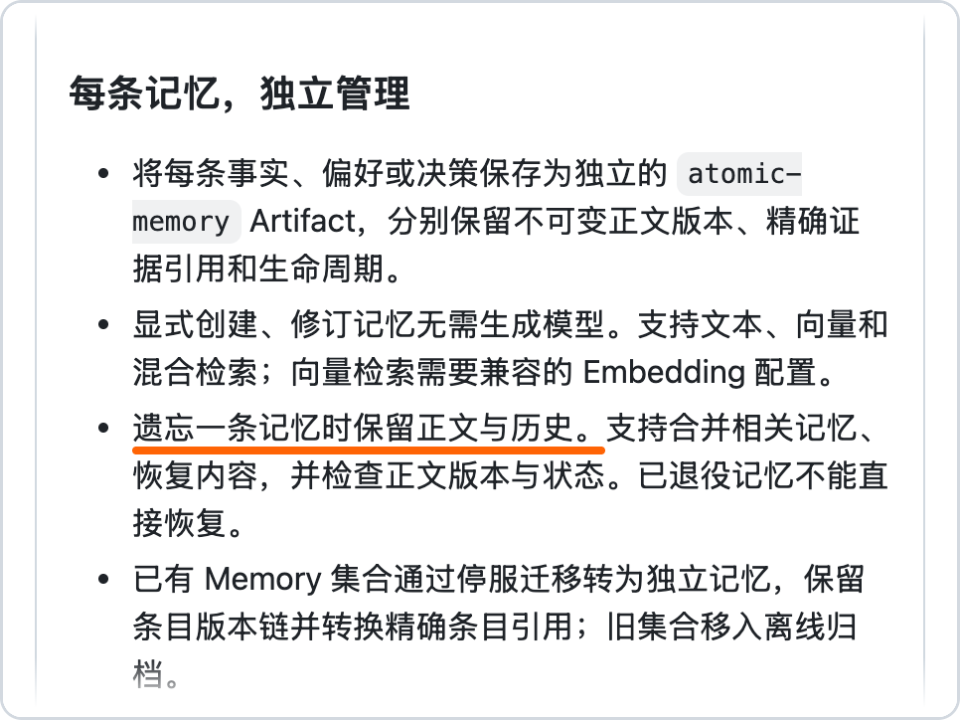
图 4|OceanBase PowerContext v1.3.0 的发布说明,截于 2026-10-17。见参考资料 [3]
【S评】PowerContext 的遗忘是「停用」:这条记忆不再被使用,但正文和历史都在,可以审计,可以追溯。对项目知识来说这很合理,决策为什么变了,往往比决策本身更有价值。可是当用户说「把我的手机号忘掉」时,他要的是另一种遗忘:「抹掉」。两种遗忘都需要,系统得先分清楚自己在做哪一种。
论文:按要求删除,几乎没有系统做得到
一个以清华大学为主的作者团队,10 月 13 日在 arXiv 上提交了一篇论文,提出了专门测试记忆删除 的基准 Bemula:50 组多会话对话、135 条六种类型的删除请求、1742 道测试题,每组对话还有一个不含删除请求的对照版本。作者在三种基座模型上测了 Naive RAG、Mem0、A-MEM、LangMem、LightMem、SimpleMem 六个记忆系统。他们报告的结果是负面的:没有任何系统端到端通过超过 1.5% 的删除请求,大多数一条都没通过。要么被删的信息用简单的攻击就能问出来,要么删掉的比用户要求的多得多。
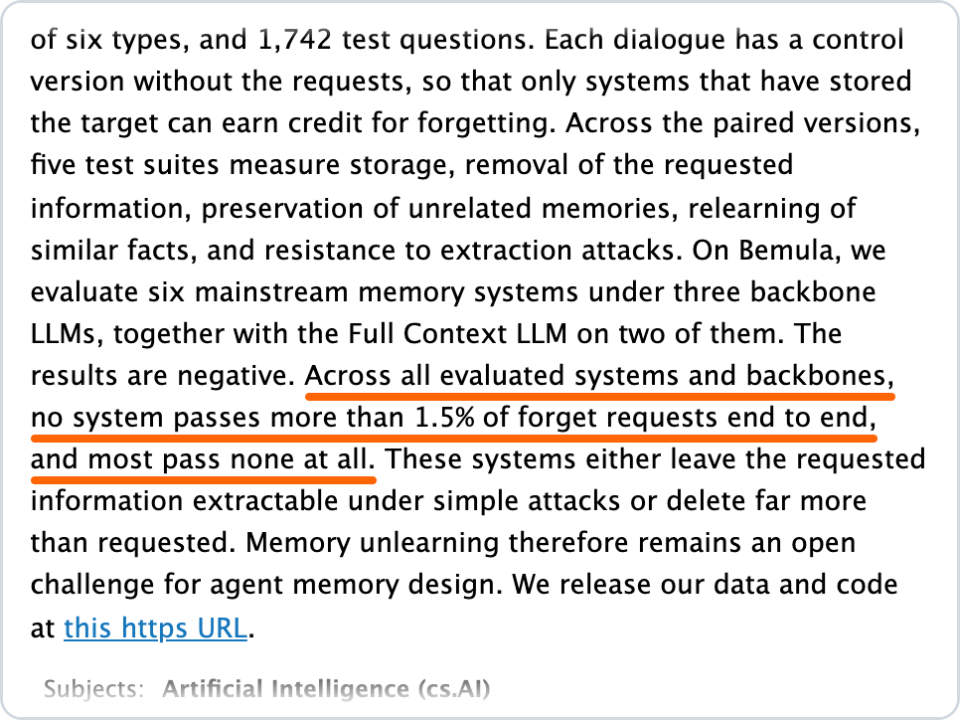
图 5|Bemula 论文的 arXiv 摘要页,截于 2026-10-17。见参考资料 [4]
同一周,还有另外两篇论文也分别从不同的方向碰到了这个问题。
-
《Keep Your Receipts》研究来源被撤回之后,Agent 建的知识图谱怎么清理:作者报告,现有流程只删直接抽取出来的事实,在他们的语料上,受污染的查询只从 32.2% 降到 28.0%。
-
《Beyond Downstream QA》则发现,被测的记忆系统只有 20% 的时候能正确判断一条新信息该新建、更新、加强还是取代旧的,而这一点在只看问答准确率的评测里完全看不出来。
【S评】三篇论文说的其实是同一件事:难以删除,是因为写入的时候没有留下够用的记录。一条记忆被谁写进来、依据是什么、后来派生出了哪些摘要和关系,写入时没记下来,删除时就只能猜。猜少了删不干净,猜多了误删。
删除的另一面:数据没给全,也要说清楚
删除,是要去除那些多了不该有的信息,而另一类问题是数据缺失了或被截断了。前面提到的 pg_vectorsearch 排序扫描被截断、Zep v4 的子图被截断,都属于这一类。Zep 的博客里提到:Agent 不会把一个不完整的邻域误当成完整的。
Cortrix 在 10 月 14 日发布了一篇文章,讲的就是这件事。文章的场景是:Agent 一次要去几个地方获取数据,而其中一处没有响应,它的请求照样会返回 HTTP 200。文章主张,这时应该把已经拿到的结果交给 Agent,同时在响应里写明缺了哪一处、能不能重试,让 Agent 不用解析错误文本就能决定下一步;如果调用方在做评测、对账、批处理,或者要给出「一共多少条」这样的数字,结果不完整就应该当作失败处理。
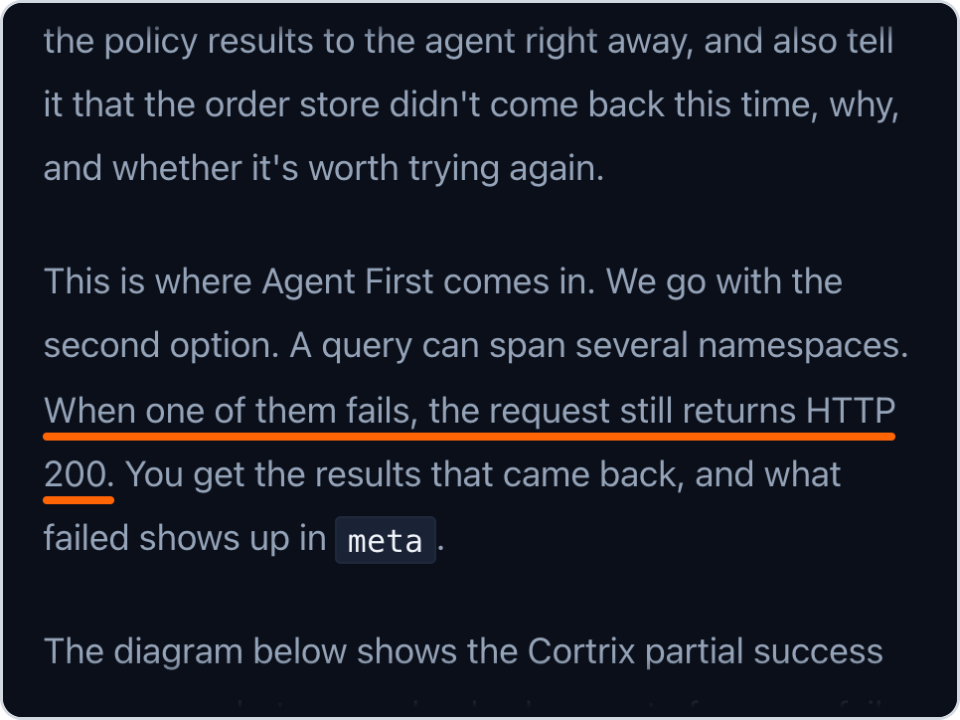
图 6|Cortrix 博客讲部分成功响应的文章,截于 2026-10-17。见参考资料 [5]
【S评】多了的要删干净,少了的要说出来,背后是同一个要求:存储层得把自己的真实状态如实告诉 Agent。Agent 没办法替存储层去猜它漏了什么、留了什么。
其他全球 Semantic 技术动态
- InfiniFlow 的 RAGFlow 在 10 月 16 日发布了 v1.0.0-rc2,对话新增 Agentic 模式,取代原来的四档思考强度,12 个内置文档解析器和 Pipeline 解析器合并,并提供 arm64 镜像。[6]
- Haystack 3.4(10 月 15 日)加了一个实验性的上下文压缩方式:旧的工具结果不再丢弃或摘要,而是写进外部存储、在原处留一个引用,Agent 需要时再读回来。[7]
- Weaviate 在 10 月 15 日披露了一个中等严重度的权限问题:
nearObject只检查了被搜索集合的权限,没有检查引用对象所在的集合,返回的距离足以还原受保护的向量。9 月 7 日发布的 v1.39.3 起已经修复。[8] - 智谱的 GLM-Legal(10 月 12 日)在 HN 上拿到 674 points,它强调法律 Agent 要在事实、条文和结论之间保持完整的链条,示例里的判断都附上了出处,引用来源文档和具体法条。[9]
本周的判断
【S总评】过去一年,Agent 记忆比的是记得多、找得准。而近期,几家厂商和研究者都开始思考另一面的问题:删除。删一条记忆之前,要先回答三件事:它是怎么来的,这次是停用还是抹掉,它在索引、摘要和图谱里,是不是已经衍生出了别的表述。这三件事,都得在写入或衍生扩展的时候就记下来。
留给读者的问题
如果用户现在要求你的 Agent 删掉一条记忆,你能说清它在几个地方留下了痕迹吗?正文、向量、摘要、图谱、日志,哪些删得掉,哪些你其实不知道?欢迎在 X 或 LinkedIn 上告诉我。
参考资料
- [1] Tiger Data, pg_vectorsearch 0.1.0 发布说明(2026-10-13):https://github.com/timescale/pg_vectorsearch/releases/tag/v0.1.0;发布博客:https://www.tigerdata.com/blog/announcing-pg_vectorsearch-scalable-open-source-vector-search-postgresql;HN 讨论:https://news.ycombinator.com/item?id=50086165
- [2] Zep, Zep v4: the Context API for agents(2026-10-14):https://www.getzep.com/blog/zep-api-for-agents/
- [3] OceanBase, PowerContext v1.3.0 发布说明(2026-10-12):https://github.com/oceanbase/powercontext/releases/tag/powercontext-v1.3.0
- [4] Bofan Xie 等, Can Agents Forget When Asked? A Benchmark for Memory Unlearning in LLM Agents(arXiv:2610.18052,2026-10-13):https://arxiv.org/abs/2610.18052;Vishisht Choudhary, Keep Your Receipts: Trustworthy Cleanup of Agent-Built Knowledge Graphs(arXiv:2610.17719,2026-10-13):https://arxiv.org/abs/2610.17719;Sebastian-Antonio Toma 等, Beyond Downstream QA: Rethinking How We Evaluate Agent Memory(arXiv:2610.22209,2026-10-15):https://arxiv.org/abs/2610.22209
- [5] Cortrix, Agent First Design: HTTP 200 Doesn’t Mean You Got Everything(2026-10-14):https://cortrix.ai/blog/agent-first-partial-success/
- [6] InfiniFlow, RAGFlow v1.0.0-rc2 发布说明(2026-10-16):https://github.com/infiniflow/ragflow/releases/tag/v1.0.0-rc2
- [7] deepset, Haystack v3.4.0 发布说明(2026-10-15):https://github.com/deepset-ai/haystack/releases/tag/v3.4.0
- [8] Weaviate, Weaviate security release: nearObject(2026-10-15):https://weaviate.io/blog/weaviate-security-release-nearobject-2026
- [9] 智谱 Z.ai, GLM-Legal: Advancing Agentic Legal Intelligence(2026-10-12):https://z.ai/blog/glm-legal;HN 讨论:https://news.ycombinator.com/item?id=50058507