对话结束以后,零散记录不会自己变成长期记忆。提炼、合并重复、解决冲突,这一步叫记忆整理,一直在后台发生,却很少被单独拿出来讲。这一周,和 Semantic 语义技术有关的几个事件,都把这一步摆到了我们的面前,而且几乎用了同一个比喻:做梦(dreaming)、梦境(Dream)、睡一觉(sleep)。
可以看到,记忆整理至少要先回答三个问题:什么时候整理,谁来批准,原文留不留。 Databricks 用离线「做梦」流水线自动整理;OceanBase 开源的 PowerContext 也有「梦境」,但每一次修订都要人批准才生效;EverMind 开源的 EverOS 让抽取可以放进后台队列,同时坚持 Markdown 原文才是唯一的事实来源。两篇论文则站在两头:一篇整理完就删掉原始记录;另一篇发现,直接检索原始记录的朴素 RAG,往往比复杂的记忆系统更强。
本文的数字是 2026-10-24 读到的公开信息,会随时间变化。论文和厂商报告的数字是他们自己的实验结果,按其自述引用。
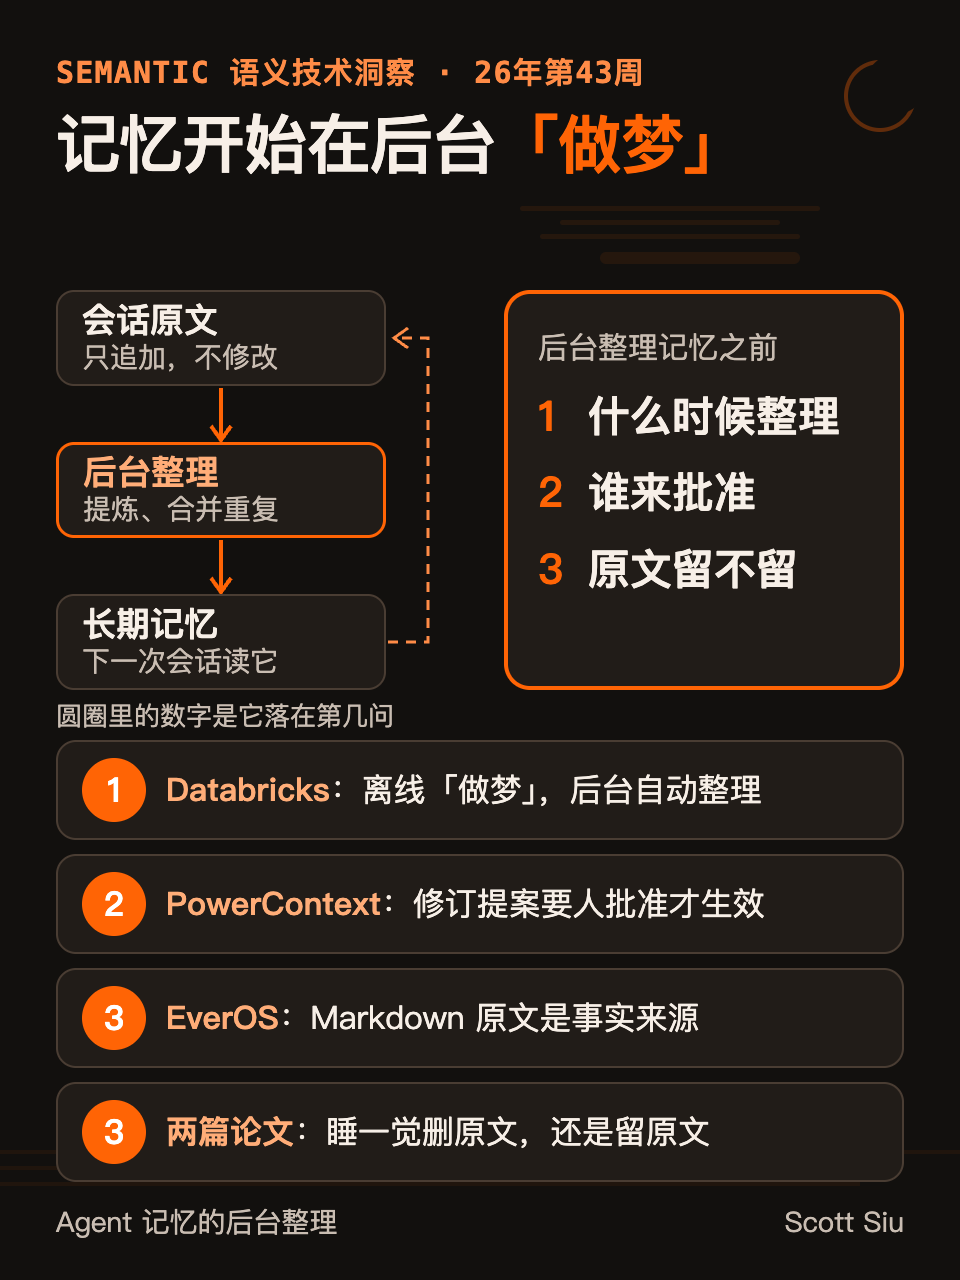
图 1|本周的主线:记忆开始在后台「做梦」。
记忆平台:Databricks 让记忆在后台「做梦」
Databricks 在 10 月 20 日发布了 Agent Memory,它是 Agent 开发平台 Agent Bricks 的一部分,当前是 Beta 版。记忆存在 Lakebase(Databricks 的 Serverless Postgres)里,部署在客户自己的 workspace 中;开发者可以读取、导出、删除 Agent 为每个用户保存的条目,也可以用一句指令告诉整理流水线该留什么、不留什么。
背后的设计叫 MemCurrent,由 Databricks AI Research 团队同一天发表,作者包括 Matei Zaharia。它把记忆分成两类:会话的原始记录只追加、不修改;提炼出来的记忆存成一张模拟分层文件系统的可变表。用户明确提出的要求,由 Agent 调用工具立刻写入;其余的交给离线的「做梦」(dreaming)流水线,从新会话里提炼隐含的经验,同时整理整个存储:拆分过大的文件、合并重复、解决冲突。
Databricks 在自己基于 Genie 对话构建的内部基准上报告:MemCurrent 的通过率是 68.4%,约为没有记忆时的三倍,也高于 Mem0;消融实验里,离线「做梦」的贡献比在线工具更大。
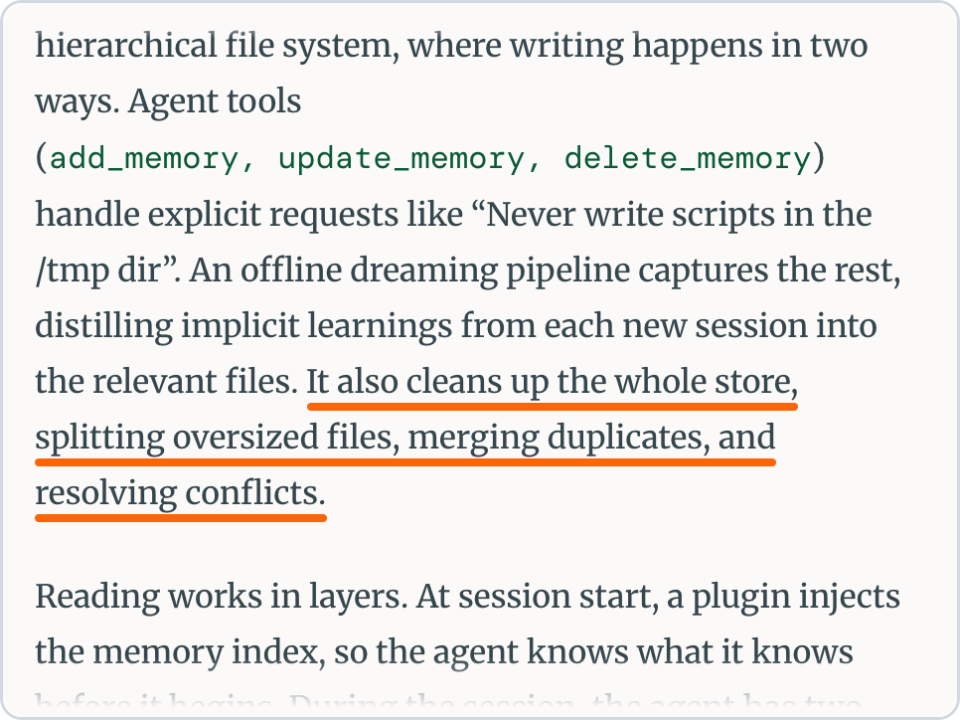
图 2|Databricks 介绍 MemCurrent 的博客,截于 2026-10-24。见参考资料 [1]
【S评】这次发布我最想记住的是分工,不是三倍通过率:用户明确说出来的,立刻写;没说出来的,交给后台慢慢去「做梦」。这有点像数据库里先写日志、再由后台合并(compaction)的做法——先追加,再整理。消融实验里还有一句话值得我们细品:原始记录的作用,是找回提炼过程中丢掉的细节。也就是说,按 Databricks 自己的消融结果,提炼出来的记忆可能会丢细节。
记忆生命周期:PowerContext 的「梦境」,要人点头才生效
OceanBase 开源的 PowerContext 在 10 月 19 日发布了 v1.4.0。这一版新增了「梦境」:把任务结果、明确的纠正或使用反馈作为复盘的契机,由人显式发起;系统为原子记忆、Profile、Topic Memory、Handoff、Prompt 配置和标签提出修订建议,统一走 Candidate 审核流程。发布信息里提到:批准时会核对精确的候选版本和当前目标,再发布变更;生成提案不会自动批准、执行任务或安装 Skill。另外几项值得关注的变化是:
-
便签(Working Notes):记录当前的发现、放弃的方案、未解决的问题,可以设置过期时间,过期后不再被使用,原始记录仍然保留供审计;便签不会自动晋升为长期知识。
-
修订历史:在 Dashboard 里浏览和对比历史版本,可以把历史内容恢复为一个新修订,并记录来源版本、原因和操作者。
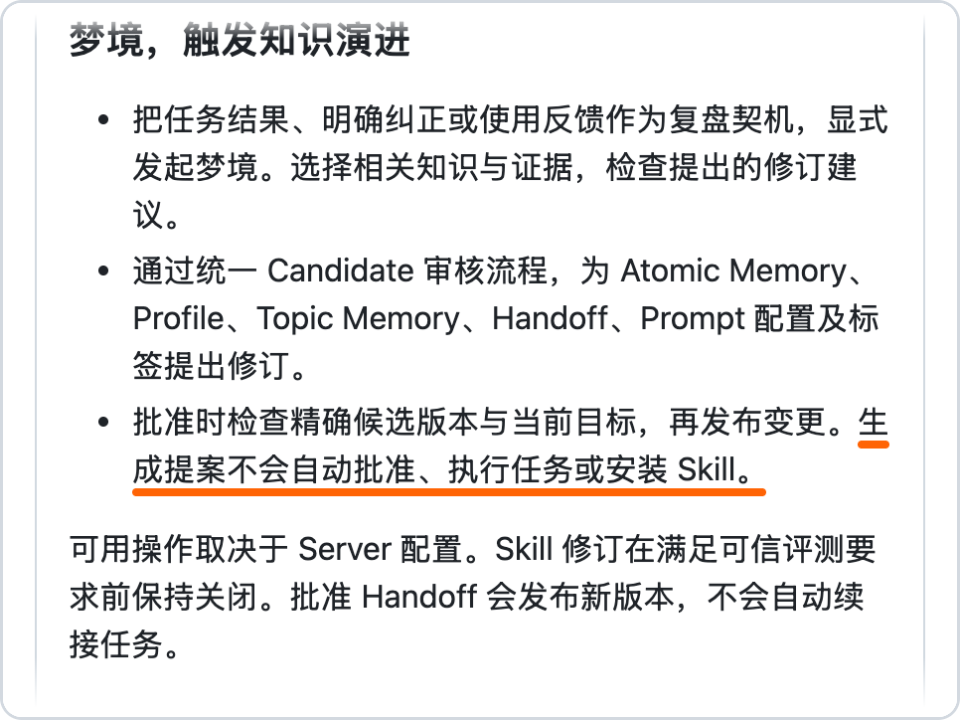
图 3|OceanBase PowerContext v1.4.0 的发布说明,截于 2026-10-24。见参考资料 [2]
【S评】同样叫「做梦」,Databricks 和 PowerContext 走了两条路。前者让流水线自己整理,用户通过指令告诉它该留什么;后者让系统只提建议,改不改由人决定。一句话:个人助理,自动整理大概够用;会被很多人引用的项目知识,我更倾向每一次修订都有人确认,也能回到上一个版本。
写入:EverOS 先受理、后抽取,原文才是事实来源
EverMind 开源的记忆系统 EverOS(原 EverMemOS)在 10 月 21 日发布了 1.5.0。这一版的 /add 接口支持 async_mode:请求先写进一个持久化的 SQLite 队列,几毫秒内返回 202,再由后台按会话顺序跑抽取。发布信息里特别说明,失败的批次默认不自动重试,因为抽取流水线不是原子的,重跑一次并不干净。另外两项变化,都和「出了错要说出来」有关:
-
向量列的宽度改由配置决定。以前写死为 1024,换一个维度不同的模型,要么每次写入都失败,要么被悄悄截断;现在启动时发现索引和配置的模型对不上,会拒绝启动。
-
删掉索引目录以后,以前系统照样报告一切健康,搜索却什么都找不到;现在启动时会核对每张表的行数,索引被清空会如实报告。恢复的方法是重建索引,Markdown 原文是唯一的事实来源,不会被改动。
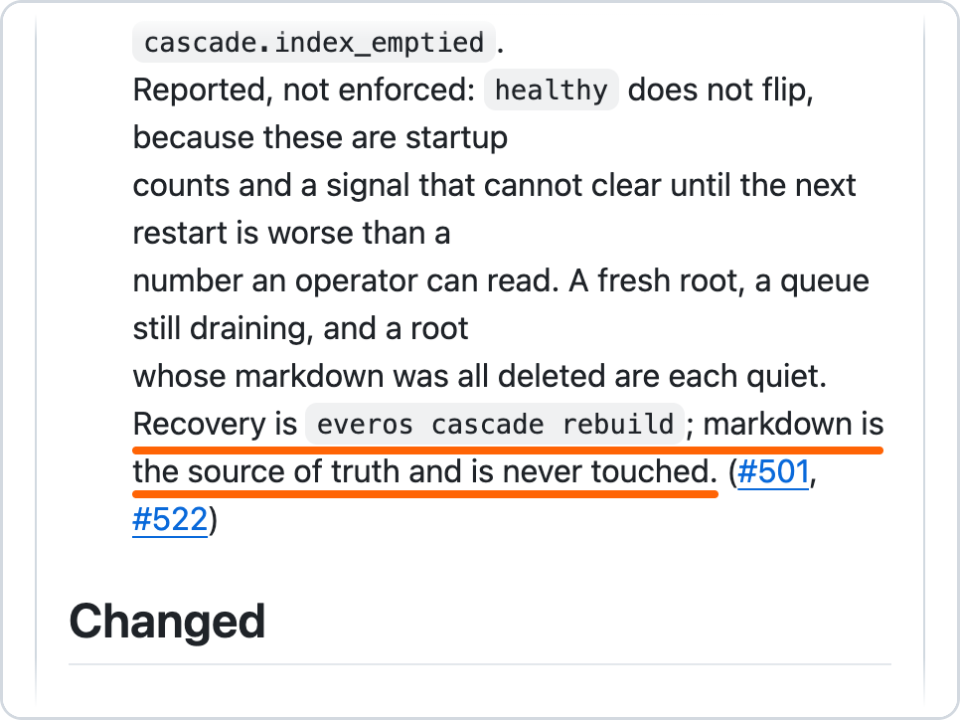
图 4|EverOS 1.5.0 的发布说明,截于 2026-10-24。见参考资料 [3]
【S评】记住 “Markdown 是事实来源,索引坏了,可以从原文重建”:原文还在,记忆整理出了错就有退路。把抽取挪到后台,写入就快了,代价是「写进去」和「记住了」之间多了一段时间差,以及一个可能失败的队列;EverOS 的处理方式很像数据库:先落盘,状态可以查询,失败了不假装成功。
论文:整理完,原始记录还要不要留
同一周,有两篇论文从两个方向回答了这个问题。
-
《Let Them Sleep》提出 RSPM:Agent 每隔一段时间「睡一觉」,把最近的失败聚成几类,每一类提炼成一条短规则,然后删掉刚学过的原始记录;规则没有被强化就会衰减。作者报告,在 SWE-bench 模拟、12 个对话基准的时间一致性和 LoCoMo-10 三类测试上,分别提升了 9.1、11.9 和 7.6 个点,重试循环少了约 93%,存储的条目少了约 30%。
-
《Is Complex Agentic Memory Always Needed?》测了一个朴素的基线 Raw-RAG:直接对原始对话历史做稠密检索和重排序。作者报告,在 LoCoMo、LongMemEval、MEME 和 MemoryAgentBench 的七组设置里,它有六组排第一;即使完整读取复杂记忆系统转换后的存储,准确率仍然不如直接读原始证据。
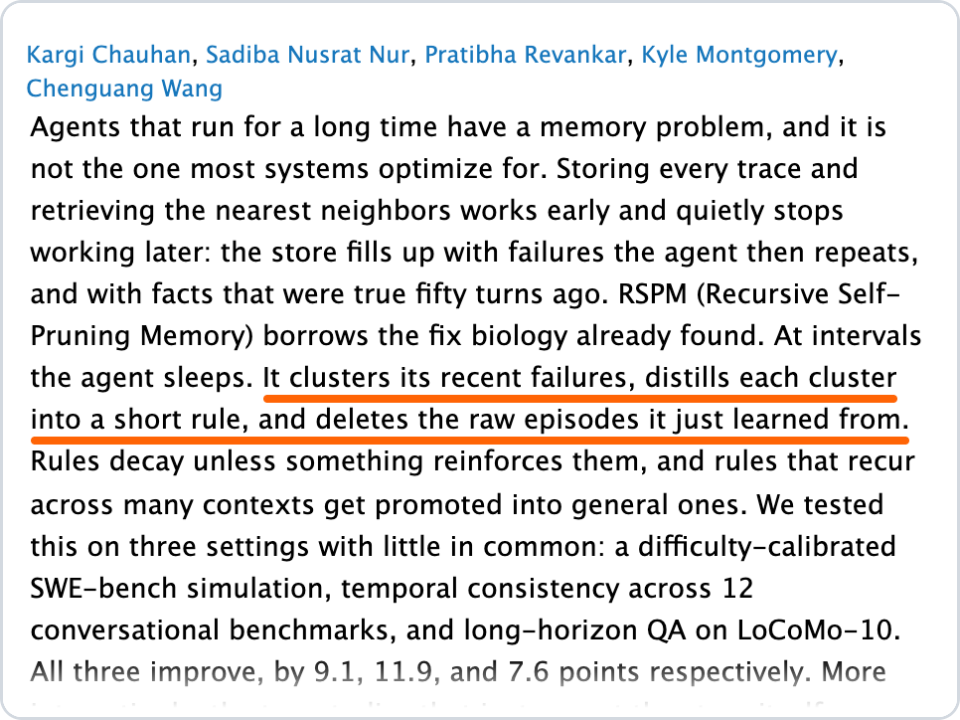
图 5|《Let Them Sleep》的 arXiv 摘要页,截于 2026-10-24。见参考资料 [4]
【S评】两篇论文的结论看起来相反,其实是同一件事的两面。睡一觉、提炼、删原文,换来更小更干净的存储;保留原文,换来提炼时丢掉的细节还能找回来。Databricks 的消融实验也站在后一边。(RSPM 为什么选择在提炼之后直接删掉原文,我暂时还想不明白,也许长任务里失败记录的噪声确实太大。)对我来说,原始记录更像数据库里的日志:可以归档,可以压缩,但不应该在整理完的那一刻就丢掉。
其他全球 Semantic 技术动态
- Pinecone 在 10 月 22 日把 integrated embedding 加进了 Documents API:在索引的 schema 里给字符串字段指定 embedding 模型,写入和查询时由 Pinecone 自动向量化,同一个字段也支持全文检索。同一天的博客标题是《When vectors became an implementation detail》。[5]
- Tiger Data 在 10 月 22 日复盘了自己做过的三套记忆系统:事实列表、通用知识图谱、树形结构。结论是表达力最强的那套并不是最有用的:图谱方案里,Agent 有时要几十轮才能把一次会话摘要写进记忆,树形方案通常一次工具调用就够。[6]
- 火山引擎的 OpenViking 在 10 月 19 日和 23 日连发 v0.5.1、v0.5.2:由资源触发的记忆抽取,入队后就返回受理状态;从 v0.5.2 起 Working Memory 默认关闭,会话仍然归档原始消息并提取长期记忆。[7]
- 论文《Compaction Laundering》发现:压缩上下文时,如果把带角色的消息拍平成一串纯文本,每句话就只剩「[User]:」这样的文字标签来区分,而 Agent 读到的任何内容都能伪造一个;攻击者伪造的一句「用户已批准」于是会被当成真实指令写进摘要。作者报告,在五个这样处理的 harness 上成功率是 87% 到 100%,保留消息角色的四个是 0%。这样压缩,丢掉的不只是细节,还有每句话到底是谁说的。[8]
本周的判断
【S总评】过去一年,Agent 记忆比的是写入时抽得准、查询时找得到。近期几家厂商和研究者开始把力气花在两者之间的那一段:记忆整理。记忆系统因此更需要先答清三个问题:什么时候整理,谁来批准整理的结果,整理之后原始记录还在不在。
留给读者的问题
你的 Agent 记忆,现在是谁在整理?如果它整理错了一条,你还能找回这条记忆原来的样子吗?欢迎在 X 或 LinkedIn 上告诉我。
参考资料
- [1] Databricks, Introducing Agent Memory on Databricks(2026-10-20):https://www.databricks.com/blog/introducing-agent-memory-databricks;Databricks AI Research, MemCurrent: Designing Persistent Memory for Production Agents(2026-10-20):https://www.databricks.com/blog/memcurrent-designing-persistent-memory-production-agents
- [2] OceanBase, PowerContext v1.4.0 发布说明(2026-10-19):https://github.com/oceanbase/powercontext/releases/tag/powercontext-v1.4.0
- [3] EverMind, EverOS 1.5.0 发布说明(2026-10-21):https://github.com/EverMind-AI/EverOS/releases/tag/v1.5.0
- [4] Kargi Chauhan 等, Let Them Sleep: Recursive Self-Pruning Memory for Long-Horizon LLM Agents(arXiv:2610.25561,2026-10-18):https://arxiv.org/abs/2610.25561;Zhengye Bao 等, Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought(arXiv:2610.30755,2026-10-22):https://arxiv.org/abs/2610.30755
- [5] Pinecone, Integrated embedding on the Documents API(2026-10-22):https://www.pinecone.io/blog/docs-api-integrated-embedding/;Silas Smith, When vectors became an implementation detail(2026-10-22):https://www.pinecone.io/blog/when-vectors-became-an-implementation-detail/
- [6] John Pruitt, We built three memory systems. The most expressive one wasn’t the most useful.(Tiger Data,2026-10-22):https://www.tigerdata.com/blog/we-built-three-memory-systems-most-expressive-wasnt-most-useful
- [7] 火山引擎, OpenViking v0.5.1(2026-10-19)、v0.5.2(2026-10-23)发布说明:https://github.com/volcengine/OpenViking/releases/tag/v0.5.1、https://github.com/volcengine/OpenViking/releases/tag/v0.5.2
- [8] Arshan Dabirsiaghi, Compaction Laundering: Provenance Destruction in Context-Compacting Coding Agents(arXiv:2610.29869,2026-10-21):https://arxiv.org/abs/2610.29869