很多团队已经在让 Claude Code、Codex、Pi Agent、OpenClaw 等 Agent 回答这样的问题:「这个模块当初为什么这么设计?」「插件和核心之间的熔断是哪个组件负责?」这些答案往往都藏在团队的几百份设计文档和讨论记录里。
要完成这个工作,最麻烦的就是,Agent 为了答对问题,往往要把命中的文件整份读进来;读进来的原文不会用完就扔,而是每一轮对话都再一次发给模型。文档越多、来回越多,它要背负的上下文内容就越重。
我们做了一次实测(不是线上虚构的事故):用同一个 Claude Code、同一个模型、同样的三道设计问题,对 2 个操作组合做对比:一组用原生 Claude Code 工具直接读文件,一组经 Cortrix 语义检索找到相关段落,再按需读原文。我们使用的测试语料,是一个真实的技术团队冻结的 932 份内部设计文档和讨论记录。
两组答案得分基本一样,但在最难的那道题上,经 Cortrix 处理的那组 Claude Code 操作节省了 43% token。整个测试进行合计,工具调用少了近三分之一,token 总量少了 27%,执行时间也缩短了 8%。
Agent 读文档,token 花在哪?
先看 Claude Code 自己的原生工具是怎么找答案的。它会先搜关键词,再把命中的文件整份读进来,一份不够就再读一份。
问题在于,读进来的内容不会用完就扔。Claude Code 每来回一轮,都要把之前的对话和已经读进来的原文,再发给模型一次。所以读得越多、来回越多,后面每一轮都背着越来越重的数据包袱。
经 Cortrix 检索时,Agent 先拿到和问题相关的段落,需要时再按章节读原文。背在身上的,主要是和这道题有关的段落和章节。
一句话:直接读文件是「整份背着走」;经 Cortrix 是「先取相关的段落」。
下面这个图,画的是两种做法在一次作答里背的东西:
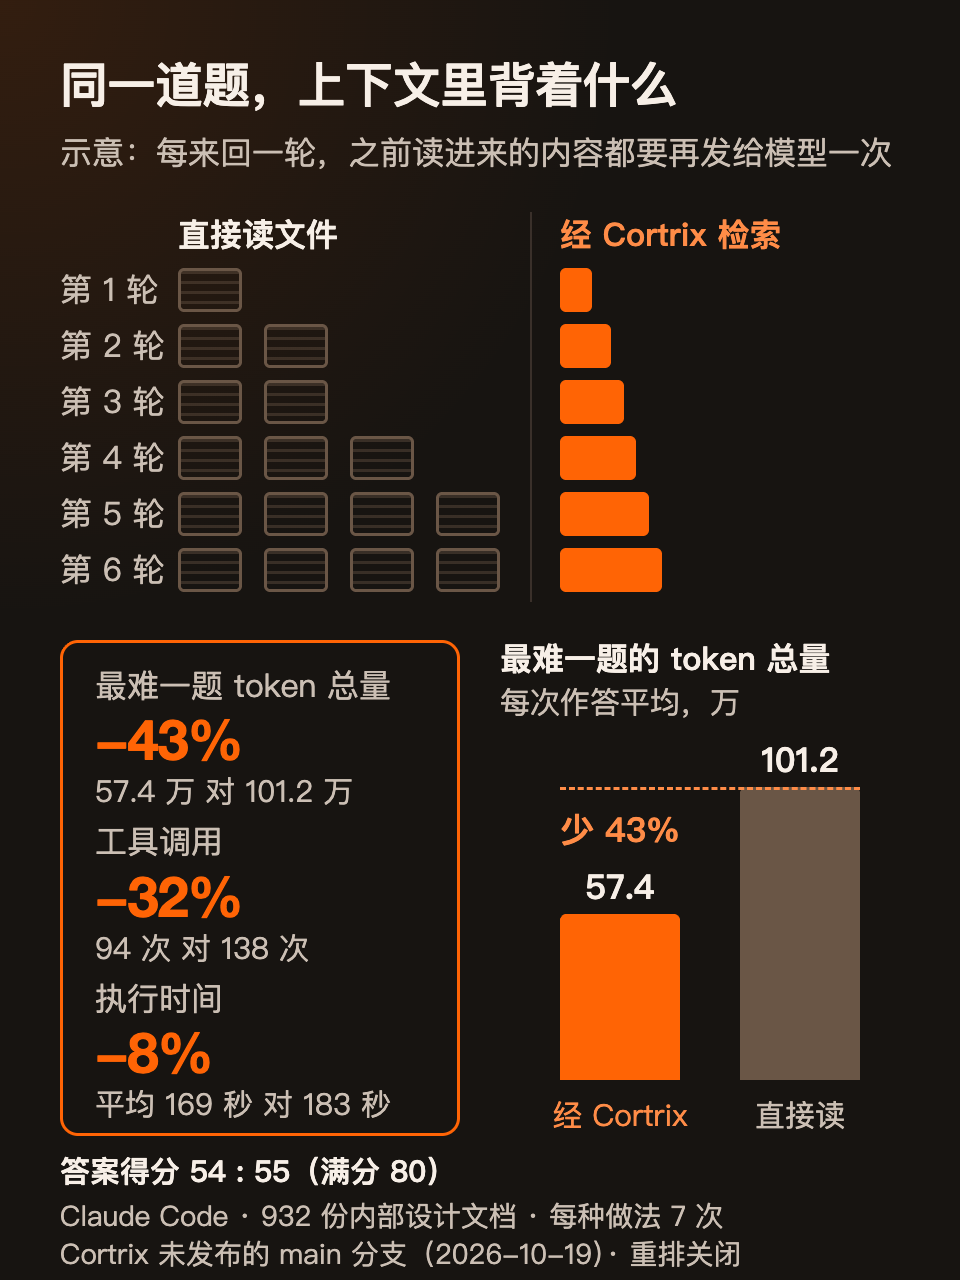
图 1:同一道题,两种做法背在上下文里的内容。
最难的那道题:得分几乎一样,token 少了 43%
三道题里,有一道两种做法的得分都不高,它要翻读的内容最多:直接读文件时,这道题处理的 token 是另外两道的两到五倍。这道题作答 3 次:
- 直接读文件,每次作答平均处理 101.2 万 token;
- 经 Cortrix 检索,每次平均 57.4 万 token,少了 43%。
这道题的得分,经 Cortrix 是 19 分,直接读文件是 21 分(满分 36),在 3 次作答的波动范围之内——质量持平,差距在背后的上下文的 token 上。
这道题差距最大,原因还是上下文越积越多。直接读文件时,另外两道每次平均只要 20.8 万和 50.9 万。在这三道题上,读得越多,每一轮重复背着的原文就越多,按需检索省下的也就越多。
步骤少了近三分之一,执行也更快
把三道题合起来看,每种做法作答 7 次,满分 80 分。答案去掉来源标记后混在一起,由同一个 LLM 裁判打分。
| 项目 | 经 Cortrix 检索 | 直接读文件 |
|---|---|---|
| 得分 | 54 / 80 | 55 / 80 |
| 工具调用(7 次合计) | 94 次 | 138 次 |
| token 总量(7 次合计) | 327.9 万 | 446.8 万 |
| 平均每次执行时间 | 169 秒 | 183 秒 |
我们可以明显看到:
- 工具调用从 138 次降到 94 次,少了近三分之一。直接读文件时,Agent 要一边搜关键词、一边整份读文件;经 Cortrix 检索时,一次查询拿回的是多份文档里和问题相关的段落。执行时间也短一些:平均每次快 14 秒,最难那道题每次快 23 秒。
- token 总量少了 27%,其中大头是每一轮重复带着的上下文,这部分少了三成(269.1 万对 385.7 万)。背着的原文少了,后面每一轮都更轻。
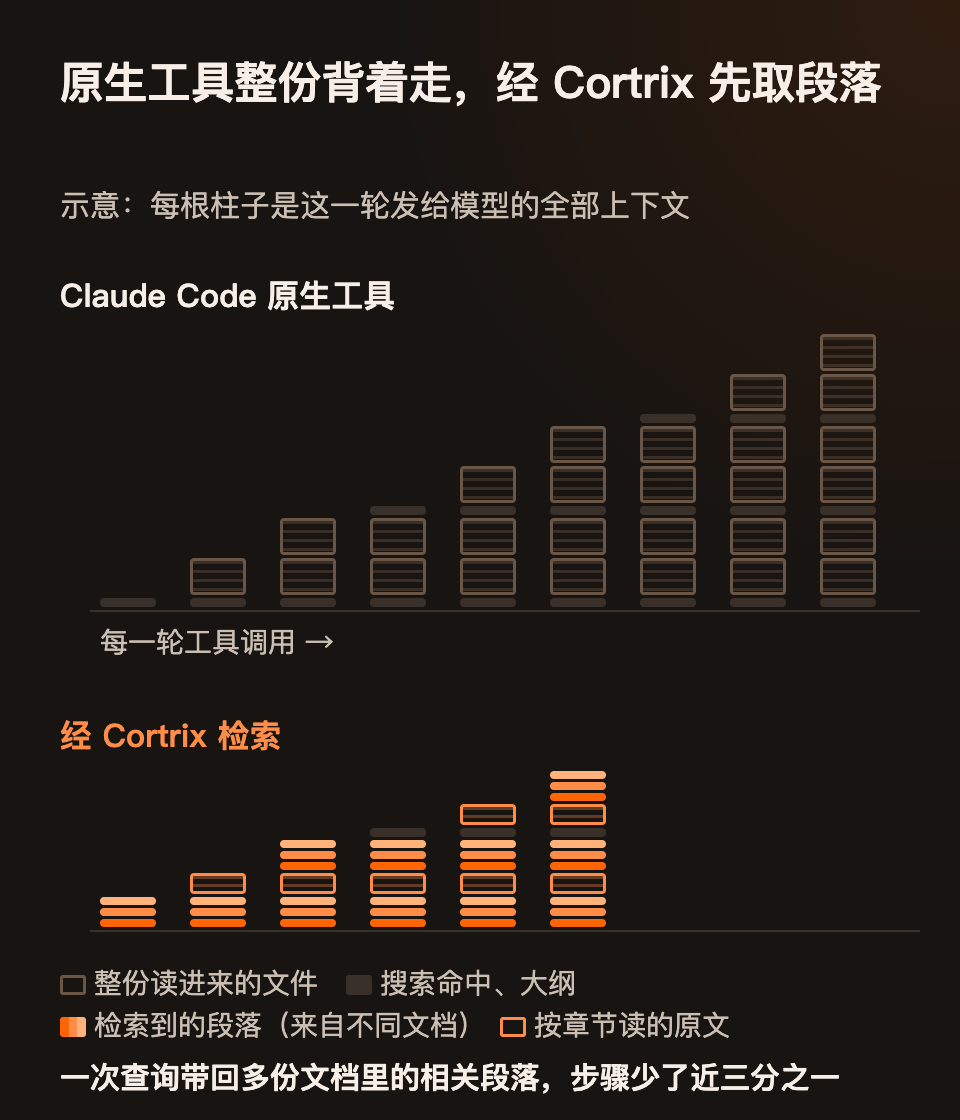
图 2:每根柱子是这一轮发给模型的全部上下文(示意)。
得分 54 对 55,在 7 次作答的波动范围之内。结论是:答案质量持平;步骤更少,token 更少,时间更短。
哪类问题最值得接 Cortrix?
三道题拆开看,效果并不平均:
- 最难的一题,token 少了 43%。
- 第二道,经 Cortrix 每次 46.5 万,直接读是 50.9 万。
- 第三道,直接读文件反而更少:经 Cortrix 每次 31.3 万,直接读是 20.8 万。
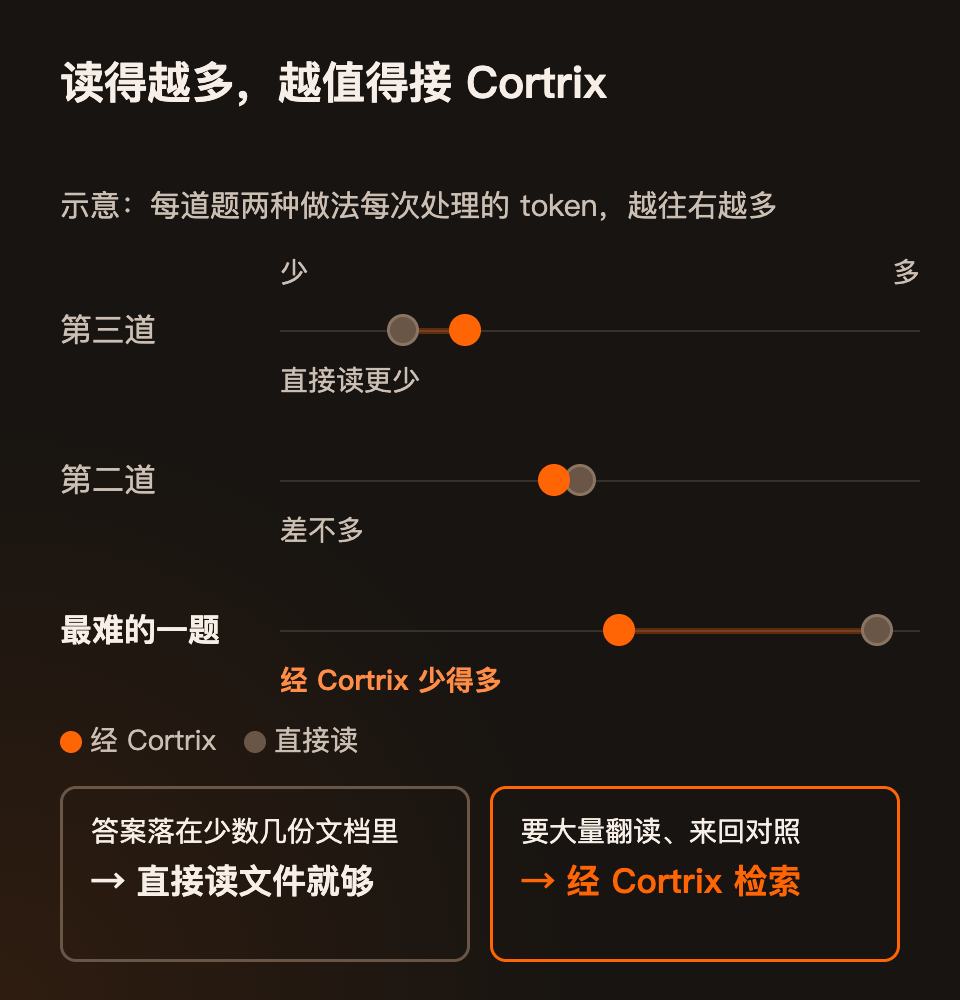
图 3:三道题两种做法每次处理的 token(示意,越往右越多)。
可以看到,文件小且读取次数不多的时候,即使整份读进来对系统负担也不重;但如果要大量翻读、来回对照的时候,背着的全文就会一轮轮叠加,像滚雪球。
所以可以这样判断:
- 设计文档、讨论记录已经多到 Agent 要大量翻读才能答一道题 → 通过 Cortrix 检索,token 上的收益很明显,执行时间也略短。
- 问题只落在少数几份文档里 → 让它直接读文件就够了。
对团队负责人:先看团队每天问 Agent 的,是不是「大量翻读才能答」的那一类。是,接检索的收益最大;不是,先别为接而接。
我们怎么测的
这是一次研究实测,用的是一个技术团队的真实资料:
- 语料:一个真实技术团队的 932 份内部设计文档和讨论记录,测试期间内容冻结不变。
- 题目:三道设计题,每道有 5 到 6 个评分要点。每种做法作答 7 次,三道题分别是 2 次、2 次、3 次。
- 客户端:Claude Code,模型是 claude-sonnet-5,推理深度 high。
- 打分:两种做法的答案去掉来源标记后混在一起,由同一个 LLM 裁判打分。
- Cortrix 版本: 2026 年 10 月 19 日
main开发分支上的版本,还不是正式发布版。查询时重排是关的。 - 接入方式: Claude Code 通过 MCP 接入 Cortrix,用查询、看大纲、按章节读原文、看目录四个工具;经 Cortrix 那组不开 Claude Code 自带的读文件和搜索工具。
- 执行时间:从启动 Claude Code 到拿到最终答案,经 Cortrix 的那组还包含了测试机远程查询的网络开销。
- 样本:三道题、每种做法 7 次、一个裁判,只够看出比较大的差异。
我们正在整理一份可以公开的数据集,到时候会再写一篇,让大家可以自己跑一遍。
试试同一类题
如果你的团队也在让 Agent 读大量内部文档,可以先按 Quickstart 把 Cortrix 跑起来,拿你们自己的设计题对照一下「直接读文件」和「经检索」背上的上下文差多少: