给 Agent 准备数据,导入往往是 Agent 自己在做:半夜整批重新导入某个项目的文档,导到一半服务被重启,没有人盯着。这时候问题不在于数据有没有丢,而在于有没有留下「只写了一半」的数据。如果存储里留着半份文档,Agent 再次检索到它的时候可能就会给出一个残缺、甚至是错误的结果。
Cortrix 的 Agent First 设计,让 Agent 不需要知道什么时候发生过崩溃:重启之后不会检索到崩溃留下的半份数据,不需要人肉跑修复命令,没做完的文档会自动修复。Cortrix 做到这一点靠的是命名空间的原子写入和恢复:每个命名空间各有一套自己的向量索引、SQLite 和写入日志,由一个写协调器(Write Coordinator)管理,一篇文档的写入要么全部完成,要么回滚,恢复也只在这个命名空间里发生(这和数据库重启时把没提交的事务回滚掉是同一个思路)。
写到一半被 kill -9
这里,我们拿一个研发助手 Agent 举个例子。它同时服务公司里的很多个项目,每个项目一个命名空间。我们模拟其中一个项目的整批导入:用 Python SDK 往一个命名空间里提交 40 篇 Markdown 文档,每篇约 29 KB,会切成 61 个数据块。等到 SQLite 里出现了未完成文档的数据块,就用 docker kill -s KILL 直接杀掉进程,连写一笔回滚的机会都不给它。
杀掉的那一刻,磁盘上是这样的:向量索引的日志里有 61 条向量,SQLite 里只有 50 个数据块,2 篇文档停在「处理中」,一篇都没有完成。向量和数据块对不上,这就形成了一个只写了一半的样例。
然后在同一份数据上重启服务,日志里出现了这一行:
[store] Recovered 2 crashed documents (2 processing, 0 deleting)-
这一行是核对和清理:写到一半的 2 篇文档被改回待处理,已经写进去的部分被清掉。
-
随后这 2 篇的任务被重新排进队列。杀进程之后大约 16 秒服务恢复健康,之后 40 篇文档陆续全部处理完。
逐条解析这个命名空间的向量日志,和 SQLite 里的数据块可以看到:2440 条向量、2440 个数据块,没有缺失任何向量数据块,也不会多出任何数据。杀进程那一刻已经写进去的 61 条向量和 50 个数据块,恢复时都被清掉,等这 2 篇重新处理时再写回去。
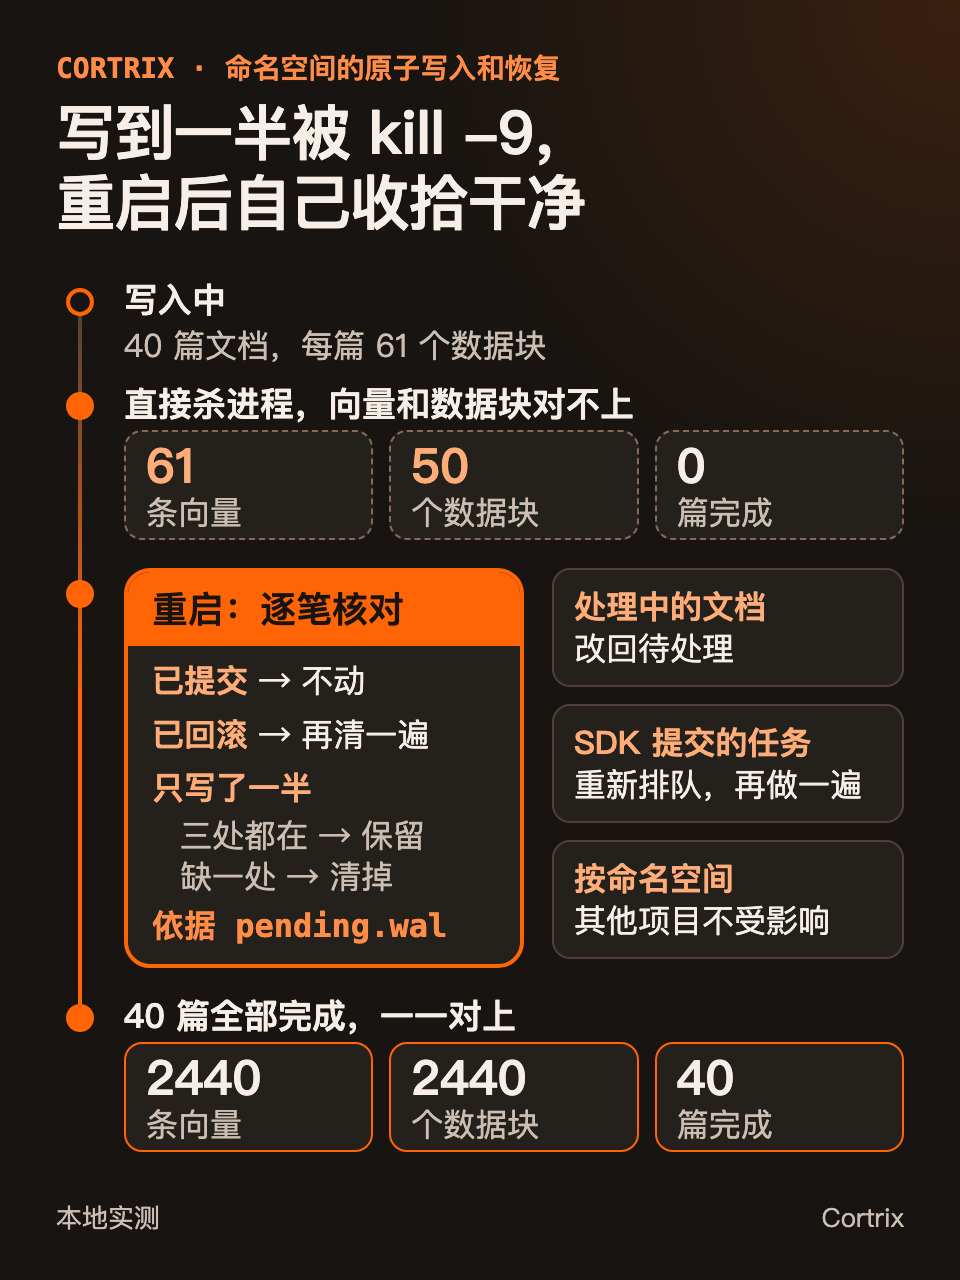
图 1|写到一半被 kill -9,重启后按命名空间逐笔核对、清理和重做。
重启的时候,Cortrix 核对了什么
一篇文档的写入,在这个命名空间的 pending.wal 里是一笔事务:先记一条 PENDING,然后把向量写进向量索引的日志 hnsw.wal,把数据块写进 store.db(有原始文件的时候还要落一份文件),全部成功之后再记一条 COMMITTED;中间任何一处失败,就记一条 ROLLBACK 并清理。
被 kill -9 的写入,在 pending.wal 里只走到了 PENDING,后面没有 COMMITTED,也没有 ROLLBACK。Cortrix 加载每个命名空间的时候,先把它的 pending.wal 从头扫一遍:
- 已经 COMMITTED 的,不动。
- 已经 ROLLBACK 的,把清理再做一遍。清理是幂等的,重复做没有问题。
- 只有 PENDING 的,逐一核对向量、数据块和原始文件是不是都在。都在,说明只差最后那条 COMMITTED,按已提交处理;缺任何一处,就把已经写进去的部分清掉。
核对完之后,还停在「处理中」的文档改回「待处理」。通过 SDK 和 MCP(Model Context Protocol)提交的文档,任务记在一张持久化的任务表里,停在「处理中」不超过 24 小时的任务,服务启动时自动重新排队,更早的会被标为失败。核对和清理都只发生在这一个命名空间的文件里,其他项目的命名空间不受影响。
Pinecone、Turso、Chroma 业界怎么做
把数据按租户或者按项目切开这个方向,业界也有不少实践。Pinecone 的文档推荐一个租户用一个命名空间。
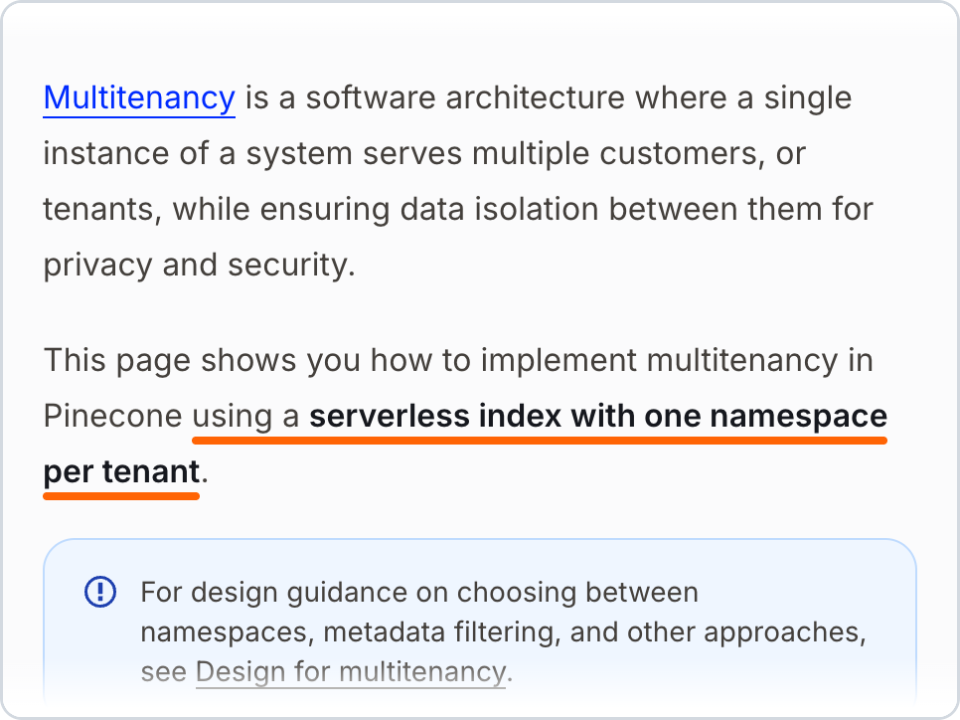
图 2|Pinecone 文档对多租户的做法,截于 2026-10-12。见参考资料 [1]
Turso 把数据库本身做成了可以按租户分开的单位,每个用户或者每个项目可以有自己的数据库。
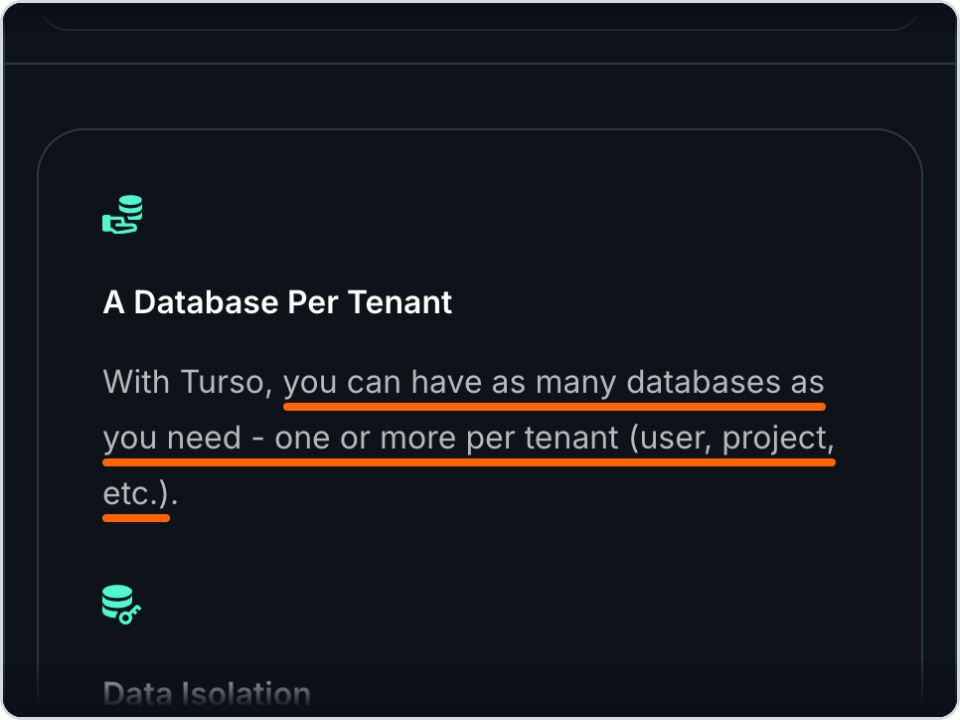
图 3|Turso 对「每个租户一个数据库」的介绍,截于 2026-10-12。见参考资料 [2]
Chroma 的架构说明里写到,它把尽可能多的工作交给 SQLite 和对象存储这类成熟的子系统。
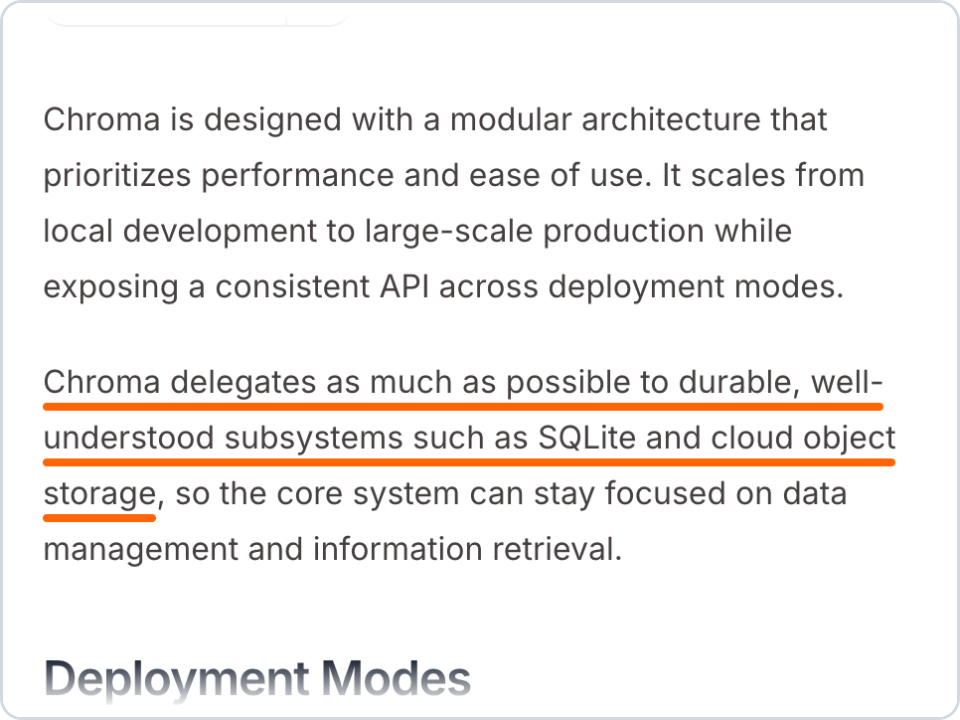
图 4|Chroma 文档的架构说明,截于 2026-10-12。见参考资料 [3]
这些材料讲的是数据怎么切分、底层用什么来存。在 Cortrix 里,向量索引和 SQLite 是两套独立的存储,所以由同一个写协调器把一篇文档在这两处(有原始文件时再加上原始文件)的写入当成一笔来管,崩溃之后也按这一笔来核对。写了一半的数据由存储自己清掉,而不是留给 Agent 去“擦屁股”。
Agent First 衡量标准
这里的 Agent First 设计,是 Agent 拿到存储给它的数据之后,能不能直接往下走,而不需要人在中间收拾或者转述。按这个标准,命名空间的原子写入和恢复做到了三件事:
- 重启之后不会检索到崩溃留下的半份数据,Agent 不需要先判断有没有发生过崩溃。
- 恢复不需要人来跑任何命令,重启就是恢复。
- 没做完的写入自动接着做,而不是停在「待处理」等人发现。
上面这三条说的都是崩溃之后。导入还在进行的时候,没处理完的文档可能已经能查到一部分;Agent 需要完整的文档,就先看文档状态是不是 ready。
什么样的数据适合按命名空间来分
我们的建议是,先看你的数据是不是天然可以分成很多份,以及每一份是不是需要单独重来。
-
如果:你的 Agent 按项目、按任务来组织知识,每一份要单独导入、单独重做,那么按命名空间来分会有帮助。一份数据导入到一半出了问题,检查和恢复都只发生在这一份里,不会牵连其他项目。
-
如果:你要分开的份数远多于 64 个,比如每个终端用户一份,那么应该换成更粗的切分方式,或者分到多个服务实例上。
用 Cortrix 还是自己写 Glue code
如果你不是使用 Cortrix 作为 Agent 的语义存储(Semantic Storage),同样的数据组织方式在别的系统里也可以做。例如,可以按前面提到的做法,一个租户用一个命名空间。我们也欢迎大家参考 Cortrix 的公开源码。
如果你想要自己实现按项目分开的存储,下面这四个问题必须处理好:
- 一篇文档要同时写进向量索引和元数据库,有时候还有原始文件。这几处必须一起完成,或者在失败时一起清理干净,否则中途失败或崩溃之后,查询会一直遇到只写了一半的数据。
- 进程在写入中途被杀掉的时候,没有机会做任何清理。重启时要能凭日志判断每一笔写入走到了哪一步,该保留的保留,该清理的清理。
- 清理完之后,没做完的写入要能自动重新开始,而不是停在「待处理」等人发现。
- 一次查询跨好几份数据的时候,要把结果合并并且去重,其中一份查不到的时候也要如实告诉调用方。
这四件事各自都要写 Glue code(胶水代码),并且需要长期维护,尤其是崩溃恢复,平时很少走到,一旦出问题又很难复现。如果你不想手搓这些代码,也不想在未来给自己管理增加工作量,那就还是直接使用 Cortrix 吧。让自己专注于处理业务工作,把复杂的数据管理交给我们。
怎么在自己的机器上验证
这篇的两个实验,我们都放进了 Cortrix 仓库的 examples/namespace-recovery。按 Quickstart 把 Cortrix 跑起来,装好 Python SDK(pip install cortrix),在仓库根目录运行下面三行:
git fetch --depth 1 origin main
git checkout FETCH_HEAD -- examples/namespace-recovery
python examples/namespace-recovery/crash_check.py
它会建一个新的命名空间,提交 40 篇文档,在写到一半的时候 kill -9 掉 Quickstart 的容器,再把它启动起来。等 40 篇都处理完,它通过公开接口核对两件事:40 篇是不是都完成了;被杀时正在写的那几篇,数据块是不是和重新干净地传一遍完全一样多,多出来的就是没清干净的残留。注意它真的会重启你的 Cortrix 容器。这是我们实跑的输出:
namespace: recovery-check-1792684166
submitted 40 documents
killed the server with SIGKILL: completed 2, processing 2, queued 36
caught mid-write: doc-002.md, doc-003.md
healthy again after 15 s
tasks after restart: completed 40
documents ready: 40/40
blocks in namespace: 2440 (sum over documents: 2440)
doc-002.md: 61 blocks after recovery, 61 in a clean upload
doc-003.md: 61 blocks after recovery, 61 in a clean upload
PASS
脚本用的 40 篇文档和前面实验里的完全一样,所以最后也是 2440 个数据块。这次被杀时正在写的是 doc-002 和 doc-003,恢复后它们各有 61 个数据块,和重新干净地传一遍完全一样。公开接口只给数据块的数量,不给向量的数量,所以脚本核对的是文档和数据块;前面向量和数据块的逐条对照,是我们解析向量日志做的。
另一个脚本 two_projects.py 建两个项目的命名空间,把同一份编码规范传给两个项目,再跨两个项目查一次:
proj-pay-1792684950      coding-standards.md    rerank_score=0.9949
proj-search-1792684950   search-api.md          rerank_score=0.0004
proj-pay-1792684950      payment-gateway.md     rerank_score=0.0001
coverage_ratio=1.0 deduplicated_chunks=1
在 v1.0.0-rc.2 上,后两条的先后可能不同。
命名空间名字后面的数字是时间戳,脚本每次都用新名字,方便反复运行。编码规范在两个项目里各有一份,结果里只出现了一次,deduplicated_chunks=1 就是被合并掉的那一份;另外两条的 rerank_score 都低于 0.001,和问题关系不大,交给模型之前可以按 rerank_score 设一个阈值把它们去掉。不过,有的结果是按整篇文档找到的,没有经过重排模型,这类结果的 rerank_score 其实是检索阶段的融合分,不能用同一个阈值来比。
如果这个实验帮你省下了自己写恢复逻辑的时间,欢迎到 GitHub 给 Cortrix 点一个 Star,也欢迎在 issue 里告诉我们你的 Agent 是怎么组织数据的。
常见问题
命名空间的原子写入和恢复是什么
命名空间的原子写入和恢复指的是 Cortrix 语义存储里写协调器(Write Coordinator)做的事:每个命名空间各有一套向量索引、SQLite 和写入日志,一篇文档的写入对这几处是一个整体,要么全部完成,要么在失败或重启时清理干净;进程崩溃后,重启时按命名空间核对、清理,再把没做完的文档重新处理。
写入的时候服务被杀掉,数据会坏吗
不会留下写了一半的数据。重启时 Cortrix 会核对每一笔没有提交的写入,缺任何一处就清理掉;只要在 24 小时内重启,通过 SDK 和 MCP 提交的文档就会被自动重新处理。
一个 Cortrix 服务里可以有多少个命名空间
当前版本一个服务实例最多 64 个。所有命名空间在启动时全部加载、一直常驻,空的命名空间每个大约占 46 MB 内存(v1.0.0-rc.2,CPU 构建)。
参考资料
- [1] Pinecone Docs, Implement multitenancy:https://docs.pinecone.io/guides/index-data/implement-multitenancy
- [2] Turso, Database Per Tenant:https://turso.tech/multi-tenancy
- [3] Chroma Docs, Architecture Overview:https://docs.trychroma.com/reference/architecture/overview
- [4] Cortrix GitHub 仓库:https://github.com/cortrix/cortrix
- [5] 本文的实验代码,examples/namespace-recovery:https://github.com/cortrix/cortrix/tree/main/examples/namespace-recovery
- [6] Cortrix Quickstart:https://cortrix.ai/docs/get-started/quickstart/
- [7] Cortrix 文档站,架构概览:https://cortrix.ai/docs/concepts/architecture/
- [8] Cortrix 文档站,查询与重排:https://cortrix.ai/docs/guides/query/
本文的命令和输出来自 Cortrix main 分支提交 f933121 的本地构建(服务自报 1.0.0-rc.2),只用 CPU,没有配置 LLM;文中讲的恢复流程在 v1.0.0-rc.2 标签里也一样。两个示例脚本在 v1.0.0-rc.2 上也跑过:crash_check.py 同样通过,two_projects.py 的差别见上文。