这周 Semantic 关注点:与其每次提问都从原始资料里翻,不如提前整理好,编成 Agent 拿来就能用的数据。
几家的说法各有侧重。Anthropic 发了篇长文,把 Claude 的记忆拆开讲:该记什么、记错了怎么改、整理成 wiki 到底有没有用;Google 让 Knowledge Catalog 自己去 Jira、Confluence 里挖上下文,补出来的更新数据管理员可以审批、回滚;RAGFlow 1.0 正式版发布,官方管这叫「知识编译」,编出来的每条事实都带着原文;Zep 把 Agent 跑通过的流程编成 SKILL.md,每一步都注明出自哪次运行;PowerContext 发了 v1.5.0,产物带着血缘,这次用了哪些记忆也能通过一张回执检查。还有两篇论文泼了点冷水:记忆虽然送到了,但 Agent 多半没用上;在事实回忆任务上,压缩成摘要的记忆,反倒不如原文好使。
说白了,知识编译绕不开三件事:编什么,编完还对不对,用上了没有。
文里的数字是 2026-11-07 看到的公开信息,之后可能会变。论文和厂商的数字是发布者的论据,本文只引用原文信息。
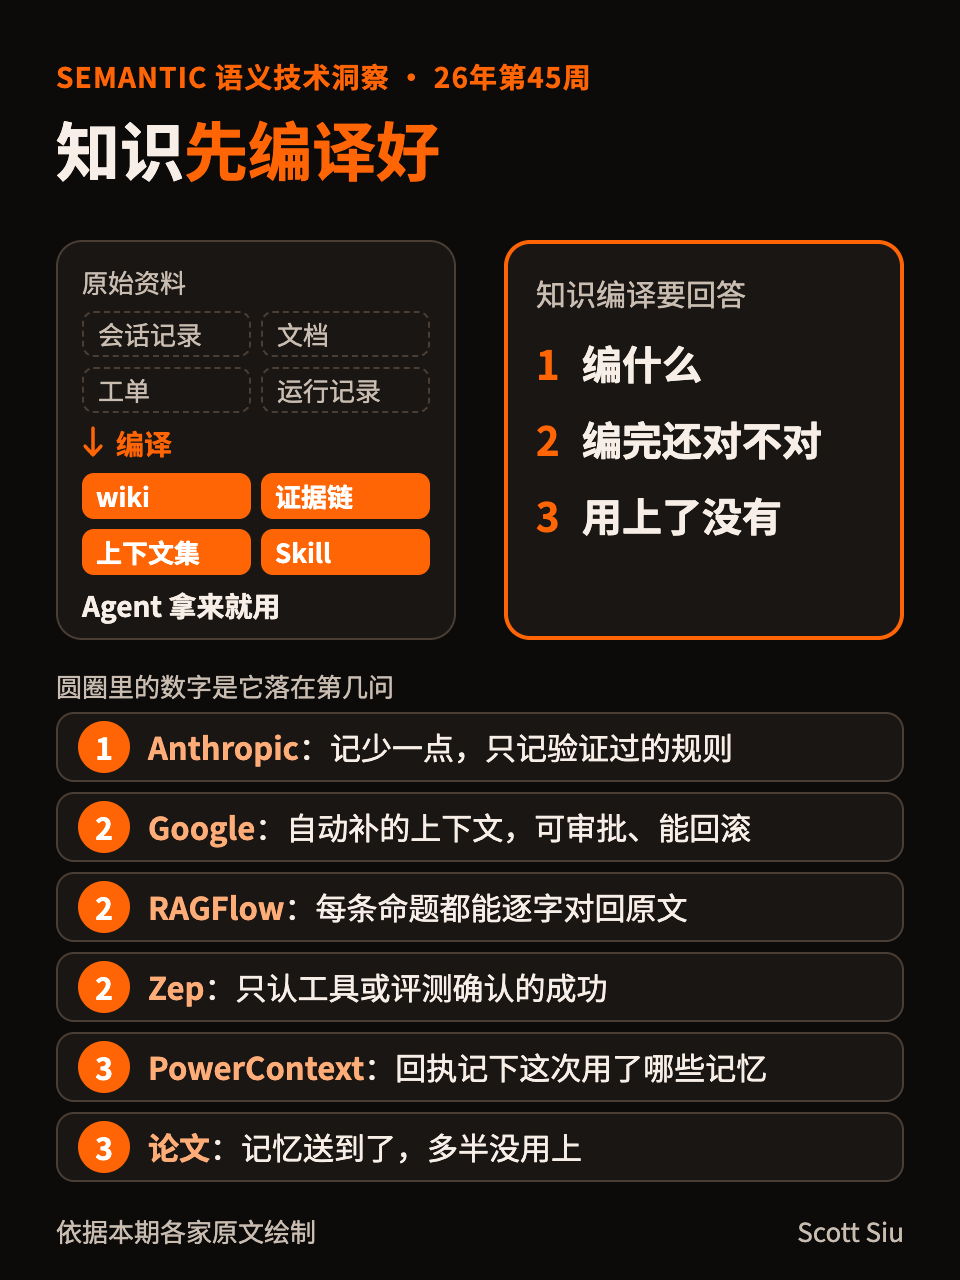
图 1|本周的主线:知识先编译好。
记忆架构:Anthropic 拆开讲 Claude 的记忆
Anthropic 11 月 6 日发了篇研究文章《The components of agent memory》,分享了他们给 Claude 做记忆的经验。几个实验挺有意思:
-
记什么:让 Claude 玩「宝可梦」,两个模型各跑一次,走到第一万步左右时对比记忆文件夹。Sonnet 3.7 啥都往里记,每场战斗、每件道具都单独一个文件,一共 413 个文件、225 个文件夹,拿了 1 个徽章;Fable 5 只写了 9 个文件加一个
global.md,拿了 4 个。屏幕上每回合都看得到的东西(钱、位置)不用记,要记的是自己琢磨出来的策略和验证过的规则。 -
怎么教:只告诉模型记忆是干什么用的,不规定怎么用,效果反而好。硬性规定「只记失败」,Opus 5 和 Opus 4.7 从记忆里拿到的提升就少了一大截。
-
记错了怎么办:Claude 在笔记里把「宝可梦」中心的位置写反了,结果三次掉回原路。离线「做梦」时让它拿笔记去对会话原文,错的那条被改过来,Claude 就走进山洞、到了下一座城。
-
编成 wiki:在大约 35 万个文件、4.2 亿 token 的公司内部资料上,「做梦」从 2 轮跑到 128 轮,只看 wiki 答题的得分从 13% 涨到 48%;wiki 加搜索一起用,从 54% 涨到 61%(只用搜索是 53%),每题还省了约 2 万 token。也有翻车的:有一个任务的 wiki 写得比原始文件还大,等于啥也没抽象。
-
每次自动加载的那一层要小:Claude Code 的自动记忆只加载
MEMORY.md的前 200 行或 25 KB,当索引用,其余的要用时再去找。
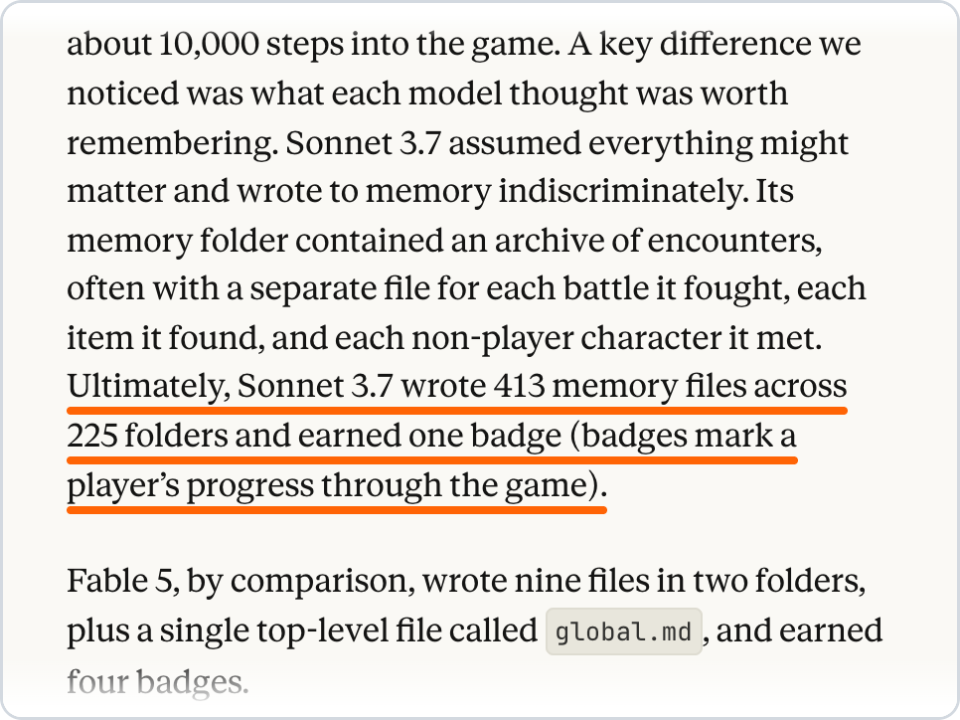
图 2|Anthropic《The components of agent memory》,截于 2026-11-07。橙色横线是本文加的重点标注。见参考资料 [1]
【S评】这里很有意思的数字是,两个模型写下的文件数量:413:9。做存储的人最容易犯的病就是「先存下来再说」,这篇等于用实验告诉大家:记得多不等于记得好,记多了还得花时间翻自己的旧账(文章里 Sonnet 3.7 有 17 步一直在建文件、删文件,游戏一步没动)。另一个细节我也很喜欢:纠错靠的是拿笔记去核对原文。合同那个实验也一样,几个 Agent 往一张共享表里写摘要,57 条条款只留下 41 条;改成每份合同一页、条款原文照抄,57 条全保住了。从语义存储 Semantic Storage 的角度看,这就是它该管的事:提炼出来的东西可以有很多层,但每一层都得找得回原文,不然出错后无法核对。
企业上下文:Google 让 Agent 自己补上下文,管理员可以审批、回滚
Google Cloud 11 月 5 日发了 Agentic Data Cloud 的一批更新,跟这期有关的是 Knowledge Catalog,Google 管它叫「通用上下文引擎」:
-
自学习增强(预览版):持续去 Google Workspace、GitHub、Jira、Confluence、SharePoint 里挖文档和工单,按大家实际在问的问题补上下文,打包成可复用的上下文集(Open Knowledge Format,OKF)。
-
新的 studio(预览版):数据管理员可以审阅、审计、批准这些自动补出来的更新,带完整的版本和回滚。
-
业务口径不交给模型猜:来自 BigQuery、LookML、Databricks、Snowflake、dbt、SAP 的可信语义模型正式可用,Agent 算净收入、流失率时,用的是业务团队同一套公式。原文说得很直白:“关键的业务定义不能交给大模型去猜”。
-
Google 说,按他们的内部基准,Knowledge Catalog 让 Agent 准确率提高近 4 倍,延迟最多降 33%,token 最多少 75%(没给测试条件)。
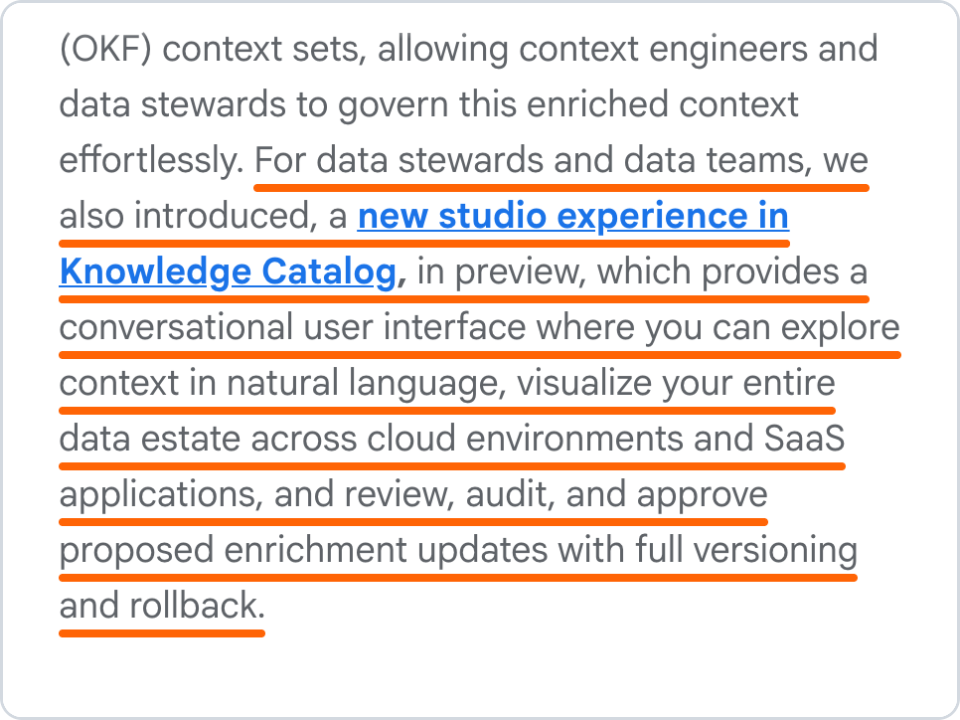
图 3|Google Cloud 介绍 Knowledge Catalog 新能力的博客,截于 2026-11-07。见参考资料 [2]
【S评】近 4 倍准确率最抢眼,不过没给条件,我只作为参考。我更在意的是分工:机器负责把散在 Jira、Confluence 里的东西编出来,人可以审批,批错了还能回滚。这其实就是数仓里的老规矩,口径由数据 owner 定,不是谁跑出来的 SQL 都可以作准。站在语义存储的角度,编译出来的上下文也得有版本、有审批状态,跟改表结构一样走流程,不能模型说改就改。
检索:RAGFlow 1.0 正式版,把知识先编译好
InfiniFlow 的 RAGFlow 11 月 6 日发了 1.0.0 正式版,官方说经过三个候选版本,可以上生产了。1.0 是用 Go 整个重写的,判断证据够不够的决策模型也在里面。前一天,官方博客发了一篇 35 分钟的长文《Context as Infrastructure》讲背后的思路,还把 RAGFlow 的定位从「端到端 RAG 引擎」改成了 Agent Native Database:
-
知识编译:把「理解」从查询时挪到建索引时,不再每次提问都从零开始。编出来的有目录树、实体关系图、时间线、wiki、本体模板,最关键的是原子命题:一句话的事实,配上原文引用,引用必须是原文里连续的一段。
-
踩过的坑:光把文档整理成目录树,对 Agent 没啥帮助,它照样靠搜索和 grep。真正有用的是挂在叶子节点上的证据链。
-
省多少:官方说,编译好的证据命中时,单题能省 90% 以上的 token,没命中只多花约 2%;在多跳的 FRAMES 基准上平均省 30% 到 40%。抽证据链也不用大模型,小模型就够。
-
证据不够就整块丢掉,不往上下文里塞;每份产物都记着来自哪篇文档、哪一段,文档删了,相关的贡献也精确删掉。答错的时候,能分清是「没找到」还是「找到了没用」。
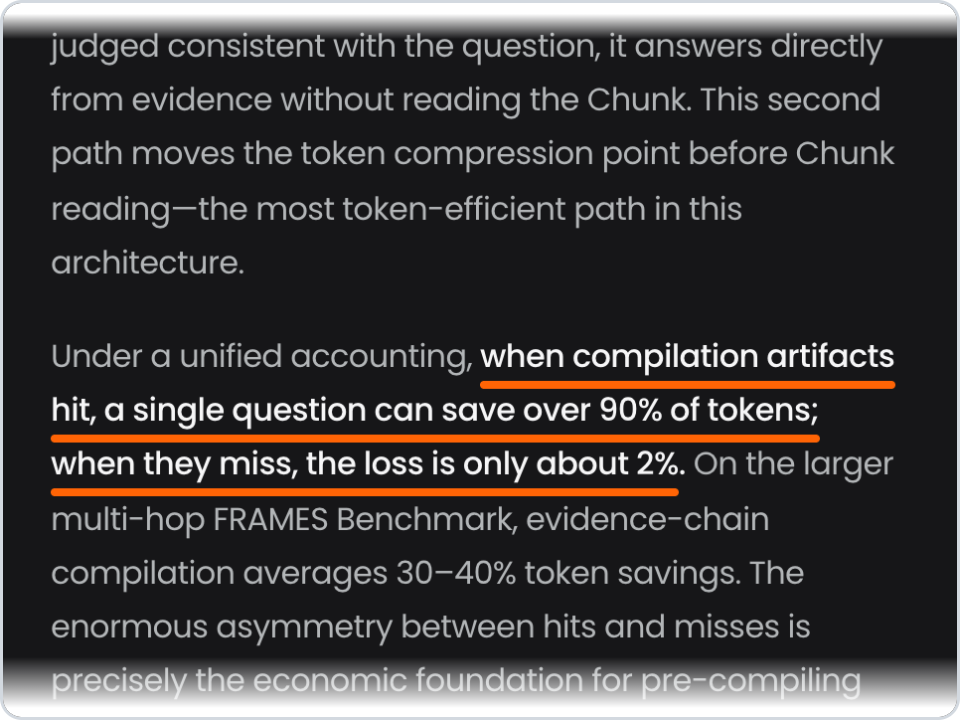
图 4|RAGFlow 博客《Context as Infrastructure》,截于 2026-11-07。见参考资料 [3]
【S评】省 90% 的 token 最抓眼球,「引用必须是原文里连续的一段」很容易被大家忽略。编译最怕编着编着就走样,摘要里多一个字少一个字,Agent 可能都会采信。RAGFlow 让每条命题都能逐字对回原文,对不上就不算,这跟 Anthropic 合同实验的结论不谋而合。它还承认光有目录树不管用,这在一堆「我们也做了树形导航」的项目里挺难得。站在语义存储的角度,编译出来的东西本质上是一种物化视图(materialized view):查得快,但得知道它是从哪几行算出来的,源数据一变就要能跟着刷新。
技能:Zep 把跑通过的流程编成 SKILL.md,Agent 自己说了不算
Zep 11 月 5 日发布 Agent Skills,创始人 Daniel Chalef 撰文,还附了 arXiv 预印本:
-
把 Agent 的运行记录编成带版本的
SKILL.md,同类任务自动归到一起,后面的运行接着改。 -
只认被外部确认成功的运行,由工具或评测说了算,Agent 自己说成功不算;入库前用代码检查每条说法都引用了运行里的事件,来自工具输出的指令直接拒掉。
-
每次修改都是不可变的版本,可以对比和恢复;源运行删了,引用它的 Skill 也跟着删;验证成功的使用会提高排名,失败会降低。
-
Zep 自测:用 Opus 5.5 运行记录编出来的 Skills 交给 DeepSeek V4.1 Flash,在 EnterpriseOps-Gym 上通过 58.3%,比不用 Skills 高 10 个点,超过了最大推理强度下的 Opus 5.5;在 τ³-bench banking 上,每个通过回合的 token 最多省 45%。Zep 也说了,现在只从成功的运行里学,模型本来就擅长的任务,提升很小。
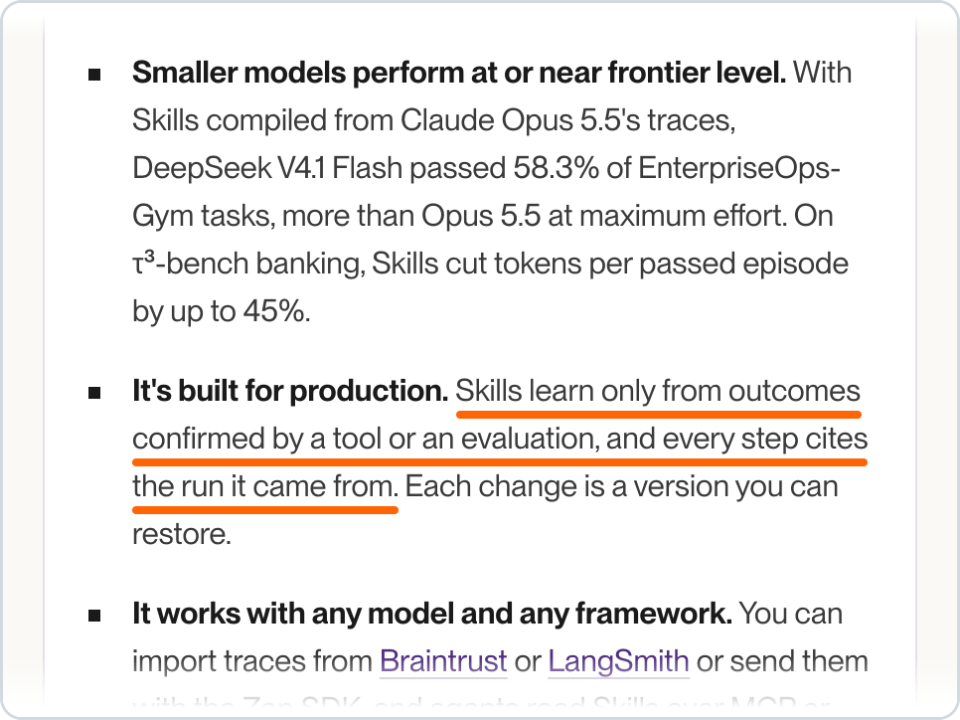
图 5|Zep 发布 Agent Skills 的博客,截于 2026-11-07。见参考资料 [4]
【S评】「Agent 自己说成功不算」我手工点赞!让 Agent 自己总结经验,最怕的就是它把一次侥幸当成规律记下来(幸存者偏差)。还有一个细节很有数据库的味道:源运行删了,引用它的 Skill 跟着删,这不就是外键的级联删除(ON DELETE CASCADE)嘛。对语义存储来说,编译产物和来源之间得有实打实的引用关系,来源没了,产物也得知道自己该失效了。
记忆平台:PowerContext v1.5.0,用了哪些记忆要说得清
PowerContext 11 月 3 日发了 v1.5.0,口号是「Not only memory, but a full story」。跟这期主线有关的是这几点:
-
Artifact 插件:可以自定义产物类型,比如事故报告、工单摘要,带版本化的 schema,记着精确的来源血缘,能做文本或向量检索。插件卸掉了,已经生成的产物照样能读。
-
上下文回执:准备上下文时可以要一张回执(
include_receipt),看这次选了哪些记忆的哪个版本、走的是哪种检索、漏掉了什么。回执里不放查询和证据的原文。 -
省 token:重复的证据用可还原的共享 JSON 编码,只有能逐字还原、而且确实更小时才用,默认关闭;准备好的上下文可以复用,但每次都重新检查当前的权限和证据,记忆被忘掉、权限被收回,复用就停。
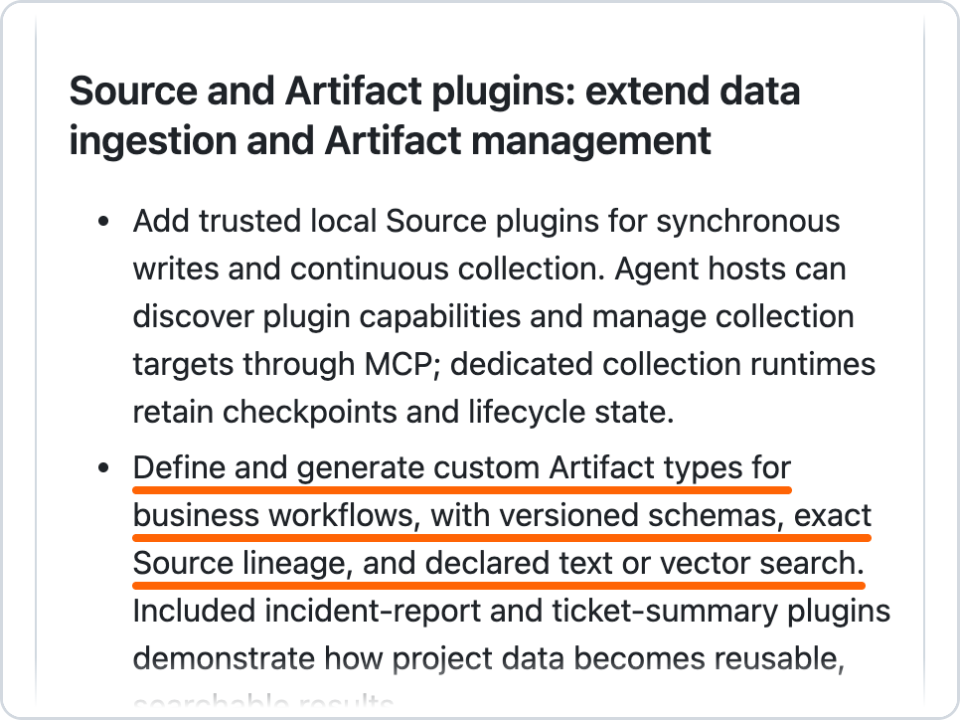
图 6|PowerContext v1.5.0 的发布说明,截于 2026-11-07。见参考资料 [5]
【S评】上下文回执是个挺实在的特性。以前 Agent 答错了,你只能猜:是没找到,还是找到了没给它,或者是给了它没用?有了回执,至少前两个能查清楚。省 token 那块也挺克制,编码需要能逐字还原才启用,默认是关闭的。发布说明里有说:“能还原,不代表模型理解得一样好,也不代表总成本更低”,这算是一句大实话了。对语义存储来说,产物要记得自己从哪来,每次用了哪些也得留下记录,出了问题才能顺着查回去。
论文:记忆送到了,Agent 多半没用上
这周两篇论文都在问同一个问题:记忆到底有没有派上用场。
-
《Delivered, Not Used》在 SWE-bench Verified 上跑了 8000 个回合,比较三套记忆系统。作者说,从解决率看,有没有记忆差不到 0.4 个百分点;顺着每一次记忆投递往下追,大多数送进去的记忆不相关,相关的大多数没被用上,其中两套系统送进去的东西,多半是 Agent 当时自己还看得见的内容。
-
《What Is This Memory Useful For?》不给每条记忆打一个固定的重要性分数,而是看它对具体任务有没有用。作者说,在事实回忆类任务上,压缩成摘要或结构化记录的记忆,帮助都比原文小,上下文总量一样时也是这样;到了软件工程和科研编程任务上,连原文记忆都看不出效果。
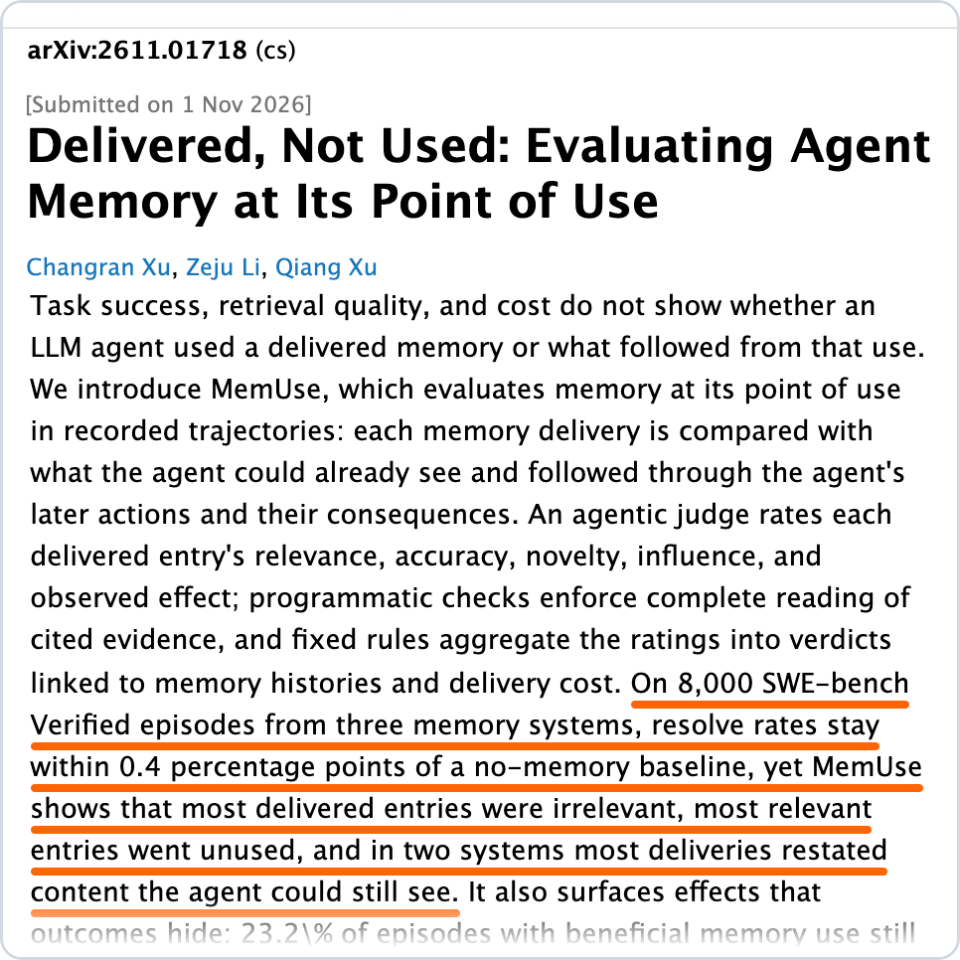
图 7|《Delivered, Not Used》的 arXiv 摘要页,截于 2026-11-07。见参考资料 [6]
【S评】第一篇真是扎心了老铁!只看解决率,你会觉得记忆系统是个摆设;拆开看才发现,问题出在送进去的东西大多不对路。这跟 RAGFlow 说的「分清没找到和找到没用」是一个意思,评测需要看到投递这一层,光看分数会被骗。第二篇提醒我们,压缩是有代价的:摘要省了 token,但可能刚好把答案那句丢了。我还是那句话,准确的信息比省下的那点 token 更重要。所以语义存储里原文不能丢,编译出来的东西是给 Agent 抄近路用的,不能替代原文。
其他全球 Semantic 相关的技术动态
- Snowflake 11 月 3 日预告了 Business Ontology(即将公开预览):每个业务术语有负责人、范围和审批状态;AI 推断出来的定义和已批准的冲突时,Agent 用已批准的那个。原话是“由负责的人决定什么成为正式定义”。[7]
- MongoDB 11 月 5 日开源了 Vercel AI SDK 的记忆集成(正式可用,Apache 2.0),分五类记忆,情节记忆默认一年不用就过期,草稿记忆一小时过期。它也老实提醒:默认由模型决定什么时候存,偶尔会漏掉一轮,生产环境建议由应用代码每轮存。前一天还发了 Google ADK 的记忆集成。[8]
- Redis 11 月 4 日给 Iris 加了 MemoryETL:从文档和知识库建记忆,分层组织,能追溯来源,也能把个人敏感信息忘掉。[9]
- Hindsight(Vectorize)11 月 3 日发了三个小模型,其中 0.8B 参数的决策模型专管记忆流程里的小判断,比如这条是不是新的、证据够不够。按他们自家的评测,部分配置下成本降了 2.5 倍。[10]
- LangChain 创始人 Harrison Chase 11 月 2 日盘点上下文工程的新难题,说记忆最难的是“想清楚该记什么”。LangChain 10 月 28 日还拿自家 OpenWiki 做记忆层,自报跨来源问题的准确率约是只用 grep 的 5 倍;再加上证据图,用
supersedes、amends这样的边记下哪份文件顶替了哪份,比只用 wiki 又高了 27%。[11] - Microsoft Foundry 博客 10 月 26 日一篇把记忆拆成 Remember、Retrieve、Revalidate、Forget 四项能力,引用自家指南的一句话:“记忆是有用的上下文,不是自动的权威”;10 月 29 日另一篇讲怎么给记忆加治理。[12]
- Qdrant 11 月 2 日解读 1.20 的性能:新加的 turbo8、turbo16 两种向量类型,存储只有 float32 的四分之一和一半,Qdrant 自测,延迟和 float32 相差不到 10%(延迟图用的是三个 1536 维数据集),float32 原件不再保留。[13]
本周的判断
【S总评】最近大家都意识到,每次提问都从原始资料里现找,又慢又贵,于是开始提前编译:wiki、证据链、上下文集、Skill。但这周几家给的教训也挺一致:记多了不如记准了,编出来的东西得能对回原文、得有人做评测确认,写入后还得查查用没用上。所以语义存储 Semantic Storage 要管的,不只是把东西存下来,还有编译出来的每一层从哪来、谁批准的、什么时候该刷新、这次用了哪些,知识编译才真正有用。
留给读者的问题
你的 Agent 记忆里,有多少是从来没被用上的?如果把它们都删了,答得会更差,还是更好?欢迎在 X 或 LinkedIn 上告诉我。
参考资料
- [1] Lance Martin, The components of agent memory(Anthropic,2026-11-06):https://www.anthropic.com/research/components-of-agent-memory
- [2] Google Cloud, New capabilities to power agents at scale with Google’s Agentic Data Cloud(2026-11-05):https://cloud.google.com/blog/products/databases/whats-new-across-googles-agentic-data-cloud/
- [3] InfiniFlow, RAGFlow 1.0.0 发布说明(2026-11-06):https://ragflow.io/docs/release_notes、https://github.com/infiniflow/ragflow/releases/tag/v1.0.0;RAGFlow 博客 Context as Infrastructure: Knowledge Compilation for the Retrieval Harness at the RAG Crossroads(2026-11-05):https://ragflow.io/blog/context-as-infrastructure-knowledge-compilation-for-retrieval-harness-at-the-rag-crossroads
- [4] Daniel Chalef, Announcing Zep Agent Skills(Zep,2026-11-05):https://www.getzep.com/blog/introducing-zep-agent-skills/
- [5] OceanBase, PowerContext v1.5.0 发布说明(2026-11-03):https://github.com/oceanbase/powercontext/releases/tag/powercontext-v1.5.0
- [6] Changran Xu、Zeju Li、Qiang Xu, Delivered, Not Used: Evaluating Agent Memory at Its Point of Use(arXiv:2611.01718,2026-11-01):https://arxiv.org/abs/2611.01718;Chih-Hsuan Yang 等, What Is This Memory Useful For? Measuring Task-Conditioned Utility in Long-Term Agent Memory(arXiv:2611.03930,2026-11-02):https://arxiv.org/abs/2611.03930
- [7] Snowflake, Business Ontology: Governed Context for AI(2026-11-03):https://www.snowflake.com/content/snowflake-site/global/en/blog/business-ontology-context
- [8] Ajay Tandon、Nasir Qureshi、Pavel Duchovny, Introducing the MongoDB Vercel AI SDK Integration: Persistent Memory for AI Applications(2026-11-05):https://www.mongodb.com/company/blog/product-release-announcements/introducing-mongodb-vercel-ai-sdk-integration-persistent-memory-applications;Introducing the MongoDB Google ADK Integration(2026-11-04):https://www.mongodb.com/company/blog/product-release-announcements/introducing-mongodb-google-adk-integration-durable-memory-agent-state
- [9] Simba Khadder, The next chapter of Redis Iris: what agents need to work in the real world(Redis,2026-11-04):https://redis.io/blog/the-next-chapter-of-redis-iris-what-agents-need-to-work-in-the-real-world/
- [10] Hindsight, Introducing Hindsight Models(2026-11-03):https://hindsight.vectorize.io/blog/2026/11/03/hindsight-models
- [11] Harrison Chase, New context engineering challenges in late 2026(LangChain,2026-11-02):https://www.langchain.com/blog/context-engineering-challenges-late-2026;Eugene Liu, Building Evidence-Grounded Agent Memory with OpenWiki and Graphs(LangChain,2026-10-28):https://www.langchain.com/blog/building-agent-memory-openwiki-graphs
- [12] Microsoft Foundry Blog, Remember, Retrieve, Revalidate-or Forget? Architecting Memory for Production AI Agents(2026-10-26):https://techcommunity.microsoft.com/t5/microsoft-foundry-blog/remember-retrieve-revalidate-or-forget-architecting-memory-for/ba-p/4564392;Abhishek Kumar, Architecting Governed Memory State for Production AI Agents with Microsoft Foundry(2026-10-29):https://techcommunity.microsoft.com/t5/microsoft-foundry-blog/architecting-governed-memory-state-for-production-ai-agents-with/ba-p/4566999
- [13] Clelia Bertelli, Faster and Cheaper Search With Qdrant 1.20(Qdrant,2026-11-02):https://qdrant.tech/blog/qdrant-1.20-performance/